9 月 23 日,Anthropic 发了一条消息,说它的 Claude 智能体在海量 DNA 序列里找到了一种新的酶系统,起名叫「阵列相关逆转录酶」,简称 ART。
几天以后,哥本哈根大学一位做计算生物学的博士生马里奥·罗德里格斯·梅斯特出来说话了。他说自己和同事从 2022 年起就在研究这类酶,Claude 公布的东西跟他们的工作重合得很明显。让人心里发毛的是后半句:这几年他们一直在用 Claude 处理科研任务,也往里面贴过还没发表的材料。
他并没有说 Anthropic 拿了他的成果。按科技日报的转述,他确定不了,也拿不出证据。Anthropic 的回应是公司此前不知道有人描述过同样的发现,Claude 也没有用用户对话记录做训练。
这件事到今天也没有结论。不过我猜不少人看到新闻时,第一反应和我差不多,会下意识回想一下:上个月贴进对话框的那份东西,现在在哪台服务器上躺着?
五周里撞车了两次
ART 不是孤例。科技日报 10 月 20 日的报道里提到,过去 5 周内至少出了两起类似的事。
另一起在数学圈。纽约大学数学家特里斯坦·巴克马斯特和 Anthropic 的数学家莱文特·阿尔波格合作研究纳维-斯托克斯问题,做了一年。9 月 7 日,巴克马斯特公布了进展,附了一份解决该问题的简化版论文。第二天,OpenAI 宣布自家 AI 智能体已经解决了这道著名难题。
巴克马斯特的疑问和梅斯特几乎一模一样:我们之前输进 OpenAI 工具的东西,会不会被拿去训练了?OpenAI 否认了,说成果公开之前,公司的研究人员和智能体都没接触过这些内容。
两边都否认,两边的科学家也都没证据。可疑虑一旦冒出来,就很难再按回去。
有些科学家已经因为担心未发表的研究被 AI 拿走,开始少用这类工具了。
ART 到底是怎么被找出来的
先把 ART 的来龙去脉说清楚,后面的讨论才有落脚点。
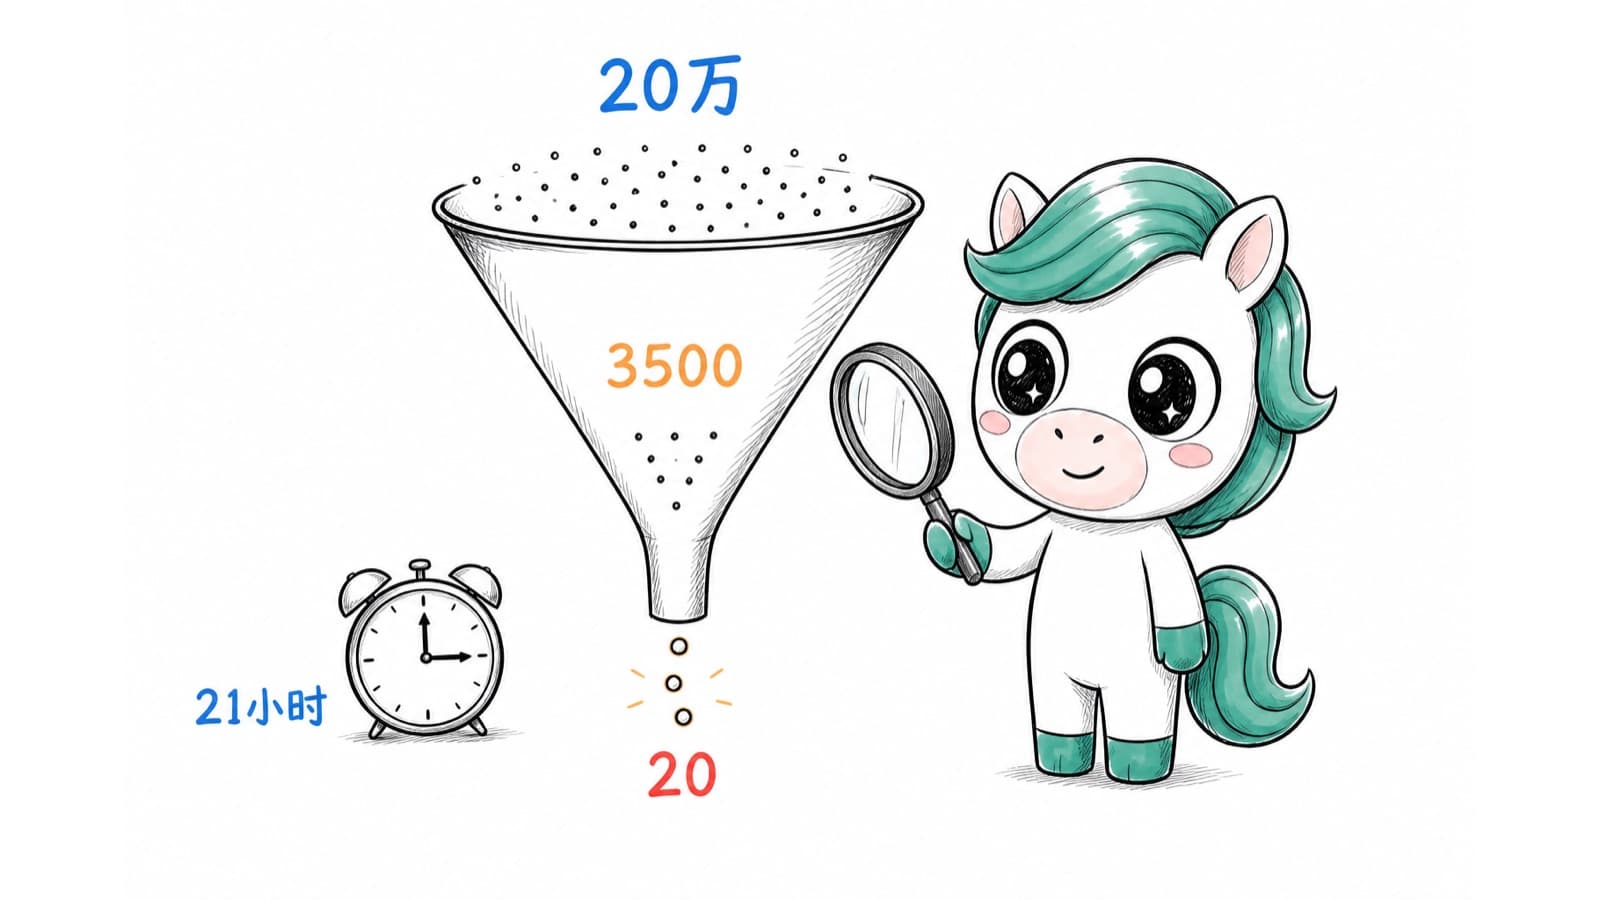
据科技日报 9 月 28 日的报道,人类只给了一个比较笼统的搜索方向,剩下的大头交给了 Claude。大约 950 个智能体一起跑了 21 个小时,消耗了约 2.1 亿个 token。它们先从将近 20 万个逆转录酶里筛出约 3500 个候选系统,再收窄到 20 个重点目标。
其中一个智能体注意到,某种不太常见的噬菌体逆转录酶旁边,排着一串间隔规律的重复 DNA,看上去有点像 CRISPR。顺着这个线索,研究人员确认这是一个由三部分组成的系统,一个逆转录酶、一个功能还不清楚的伴随基因,再加一段类似 CRISPR 的重复阵列。
接下来的湿实验是人做的。实验证明这段阵列确实会表达,能产生一组各不相同的短 RNA。至于它在细胞里到底干什么、能不能拿来做基因编辑,现在都还说不上。报道里也明确写了,目前不能把它当成基因编辑工具看待。
所以分工大概是这样的,搜索、筛选、提出假设交给 AI,动手验证交给人。Anthropic 自己的说法是,这种方式能把原本要花「数周或数月」的分析压缩到几个小时。
20 万个候选里挑 20 个,21 个小时,换成一个三五个人的课题组,这活儿可能要干上大半年。
也正因为它快,梅斯特那种「我们做了好几年的方向,被人一天就扫到了」的感受,才格外刺眼。
其实你我每天都在干同样的事
把科学家换成普通上班族,这个故事一点也不遥远。
研究生把还没投稿的实验数据贴进去,让 AI 帮忙润色讨论部分。创业者把融资 BP 整份上传,问它估值逻辑讲不讲得通。律所助理把案情摘要丢进去整理时间线。HR 一口气上传二十份简历,让它按岗位要求排个序。
这些操作都很顺手,也确实省时间。问题在于,大多数人点下「发送」的那一刻,并不清楚这份文件接下来会经历什么:存多久,谁能看,会不会进训练集,出了事找谁。
科研圈的人比一般人更在意这件事,原因很简单,在科研里,「谁先」几乎就是全部。一个思路晚发表三个月,可能就从首创变成了跟进,论文、基金、职称都跟着变。
科学家们已经开始改习惯了
科技日报 10 月 20 日那篇报道里,记了几位科学家的做法,挺有参考价值。
德国明斯特大学的生殖表观遗传学家桑德拉·劳伦蒂诺,现在只用 AI 查代码错误。查之前,她会先把代码里的参数名、变量名换成通用标签,免得系统从命名里看出她在做什么实验。
| 科学家 | 做法 | 理由 |
|---|---|---|
| 桑德拉·劳伦蒂诺(明斯特大学) | 只用 AI 查代码错误,先把变量名换成通用标签 | 系统不能从命名看出实验内容 |
| 塞缪尔·梅尔(奥克兰大学) | 禁止学生上传受保护信息,研究全程不用商业大模型 | 不知道第三方怎么处理信息,等于白送知识产权 |
| 惠康基金会等资助机构 | 明令禁止评审把保密申请书上传 AI 评估 | 外部评审一上传,申请人未公开的构想就暴露了 |
说到这儿你会发现,一个人再小心也不够。你自己守得很严,你的稿子到了审稿人手里,人家顺手贴进对话框,前面的功夫就白费了。
「关掉训练开关」能管多少
很多人的安全感来自设置页里那个开关,「不允许使用我的数据改进模型」。这个开关确实该关,但它管的范围比大家以为的窄。
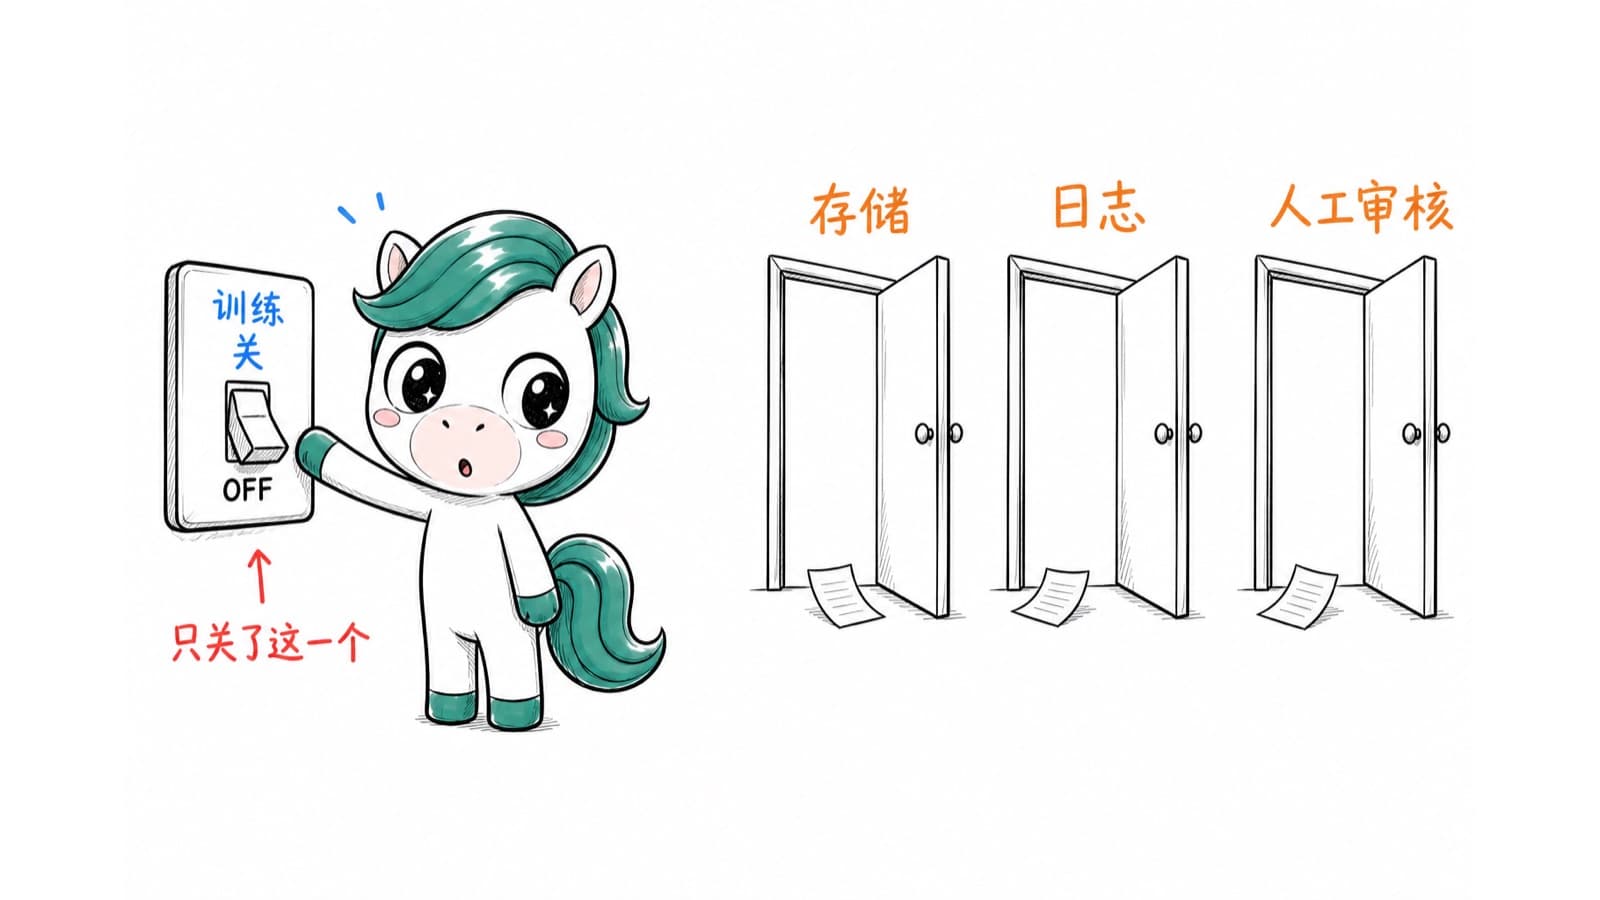
就算用户退出了模型训练,甚至压根不用这些系统,信息也未必安全。
大卫·克鲁格,Evitable 创始人
为什么这么说?你可以把训练理解成「把你的内容揉进模型里」。关掉开关,只是说不揉。至于数据在服务器上存不存、存多久、日志里留不留、出于安全审核会不会有人工查看、遇到司法调取怎么处理、服务商自己被攻破了怎么办,这些都不归那个开关管。各家的政策也不一样,个人版、团队版、企业版、API 之间的条款还经常不同。
所以真想弄明白,最靠谱的办法还是去读你正在用的那个产品的隐私条款和数据保留说明,看清楚是哪个版本。这活儿很枯燥,但总比事后猜强。
就算一份数据都没漏,AI 也可能先到
这里要把两件事分开说,不然很容易吵成一锅粥。
一件是数据泄露,你的东西被别人拿去用了。另一件是 AI 单靠公开资料,就自己走到了你的答案前面。
后一种情况,有人认为会越来越常见。美国加州伯克利 AI 安全研究机构 Resolution 的首席科学家杰弗里·欧文的看法是,就算 AI 从没碰过任何人的私人数据,人类攒下的公开文献这片「知识海洋」也够它不断找到新东西。推理能力再往上走,科学家可能会一次又一次发现 AI 已经先到了。
看看 2026 年这几个月的进展,这个判断不算夸张。科技日报 10 月 16 日的报道梳理过:5 月,《自然》杂志发表了谷歌深度思维的「协作科学家」系统和 FutureHouse 公司的 Robin 系统;7 月,Phylo 公司的 Biomni 智能体独立设计出一套完整的质粒插入实验方案,研究人员屈元昊说它做的是「从头到尾的整个流程」,只是还不能自己上手操作实验台。
同一篇报道里还有个细节很有意思。研究者菲莉娜·古克尔贝格把一个 3000 万行的数据集交给 Kosmos 系统分析,它一开始压根没理会其中一列数据,被人指出来之后才回头去看,结果找到了一个新的癌细胞特征。
AI 处理数据的量级已经是人比不了的,可它看什么、不看什么,还是需要人来盯。
那人还剩下什么
10 月 17 日到 19 日,第二届国际人工智能科学家大会开了三天,这个问题被翻来覆去地讨论。
据科技日报 10 月 20 日的报道,79 岁的诺贝尔化学奖得主迈克尔·莱维特在 ChatGPT 上线几天后就开始用了,现在手上同时跑着 6 个智能体。他的说法是,AI for Science 的本质是服务科学家的人工智能。
人工智能拥有答案,而人类需要提出问题。一个好问题的价值,已经超过执行能力本身。
迈克尔·莱维特,诺贝尔化学奖得主
图灵奖得主杰克·唐加拉提醒年轻人,AI 不可能包办一切,「我鼓励大家继续学习数学」。会上还有人提到一个挺尴尬的现象,有些模型批量产出了大量没经过验证、质量很差的数学论文。能不能判断 AI 给的东西对不对,正在变成一项硬本事。
初创公司 Adaption 的联合创始人萨拉·胡克也有类似判断:AI 智能体眼下还不太会提出那种能推动科学发现的问题,定方向、做假设,主要还得靠人。
这话听着让人宽心,可反过来想也有点紧张。如果最值钱的就是「问对问题」,那你的问题本身,也就是你那些还没发表的思路,恰恰最需要保护。你往对话框里贴的往往不是答案,是你琢磨了很久的那个问题。
主权 AI,换成大白话是什么意思
「主权 AI」这个词这两年被说得很多,听起来像是国家层面的事。落到一个实验室、一家公司身上,其实就是三个很朴素的问题。
数据存在谁的机器上?算的时候用的是谁的算力?规矩由谁来定,比如什么时候删、换不换模型、谁能查记录?这三个问题,和另一篇文章里拆开讲过的数据、算力、模型、身份四个维度,说的其实是同一件事:你能不能说清楚,自己的工作在哪台机器上运行、由谁的规则管理。
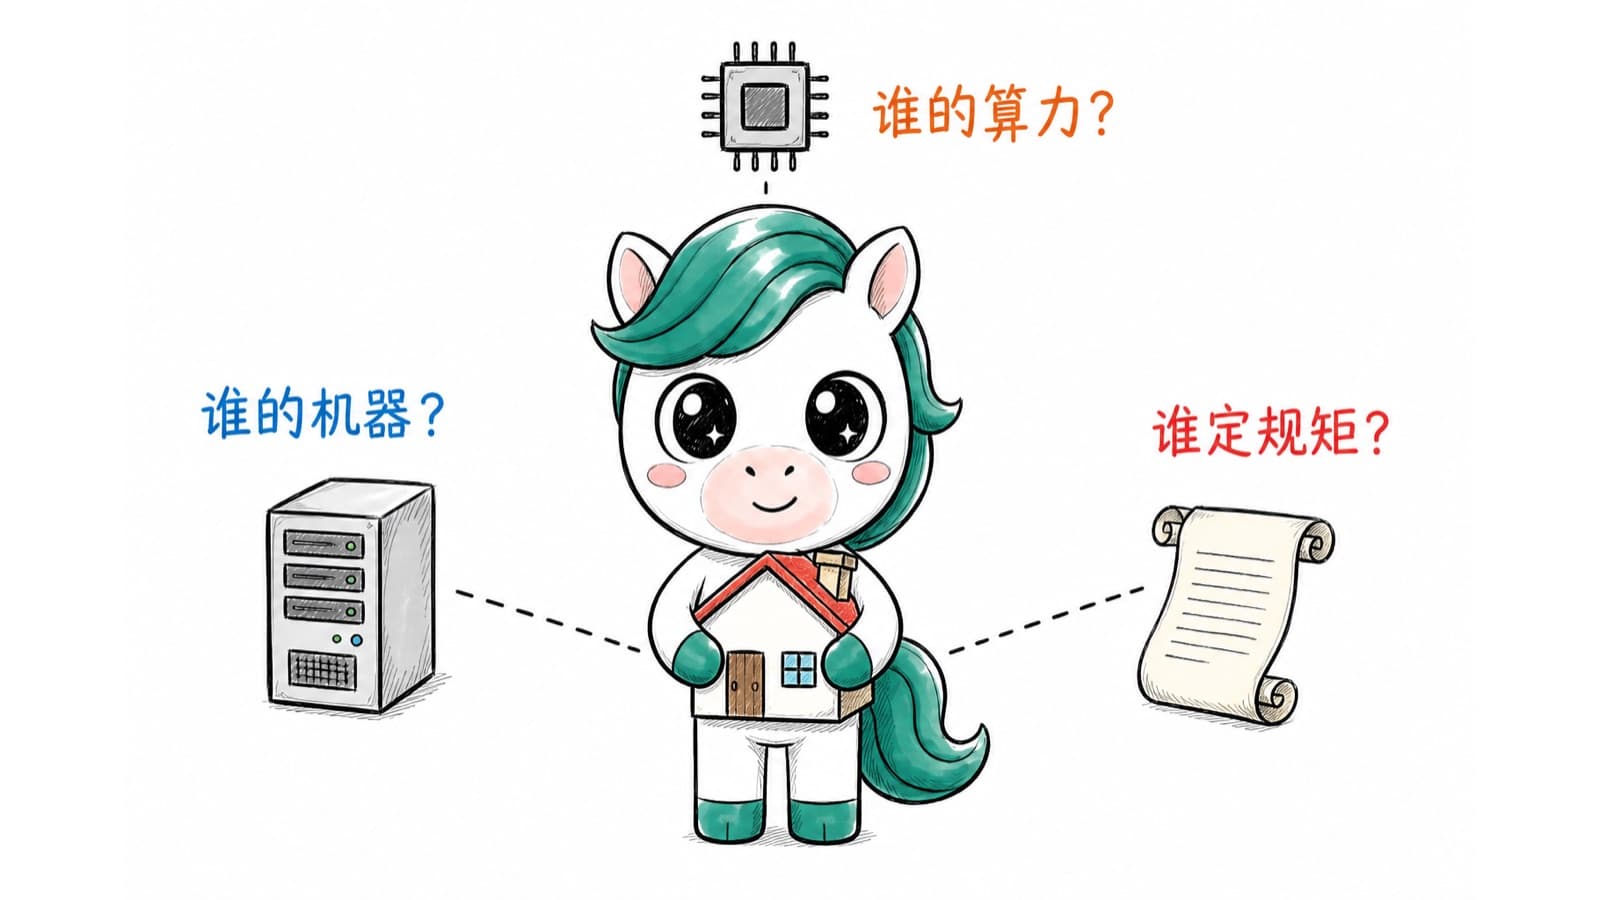
用公共云上的大模型,这三个问题的答案大部分在服务商那边。不是说服务商一定会乱来,而是你没法自己核实,只能信它。对于公开资料、日常写作,这完全没问题,便宜好用就行。可对于没发表的数据、核心配方、客户名单、在谈的合同,「只能信它」就不太够了。
把这三件事拿回自己手里,最直接的路子就是本地部署或私有部署。模型跑在自己的机器或内网里,文件不出门,日志自己留,想删就删。代价也很实在,要硬件,要有人维护,本地模型的能力通常也比最强的云端模型差一截。
所以现实一点的做法往往是混着用,敏感的走本地,公开的走云端。这本质上就是按任务路由模型,用哪个模型不取决于谁最火,取决于手上这份数据有多敏感。
💡 如何用 KarmaBox 实现?
回到开头那个研究生的场景。他想让 AI 帮忙读几十篇文献、整理实验记录、起草讨论部分,但又不想把还没发表的数据交给第三方。KarmaBox 的思路是把「能不能用 AI」和「数据放哪」拆开处理,敏感内容留在自己的设备和内网里,公开资料照样可以调用云端模型,这也是一个本地优先的工作空间该有的样子。
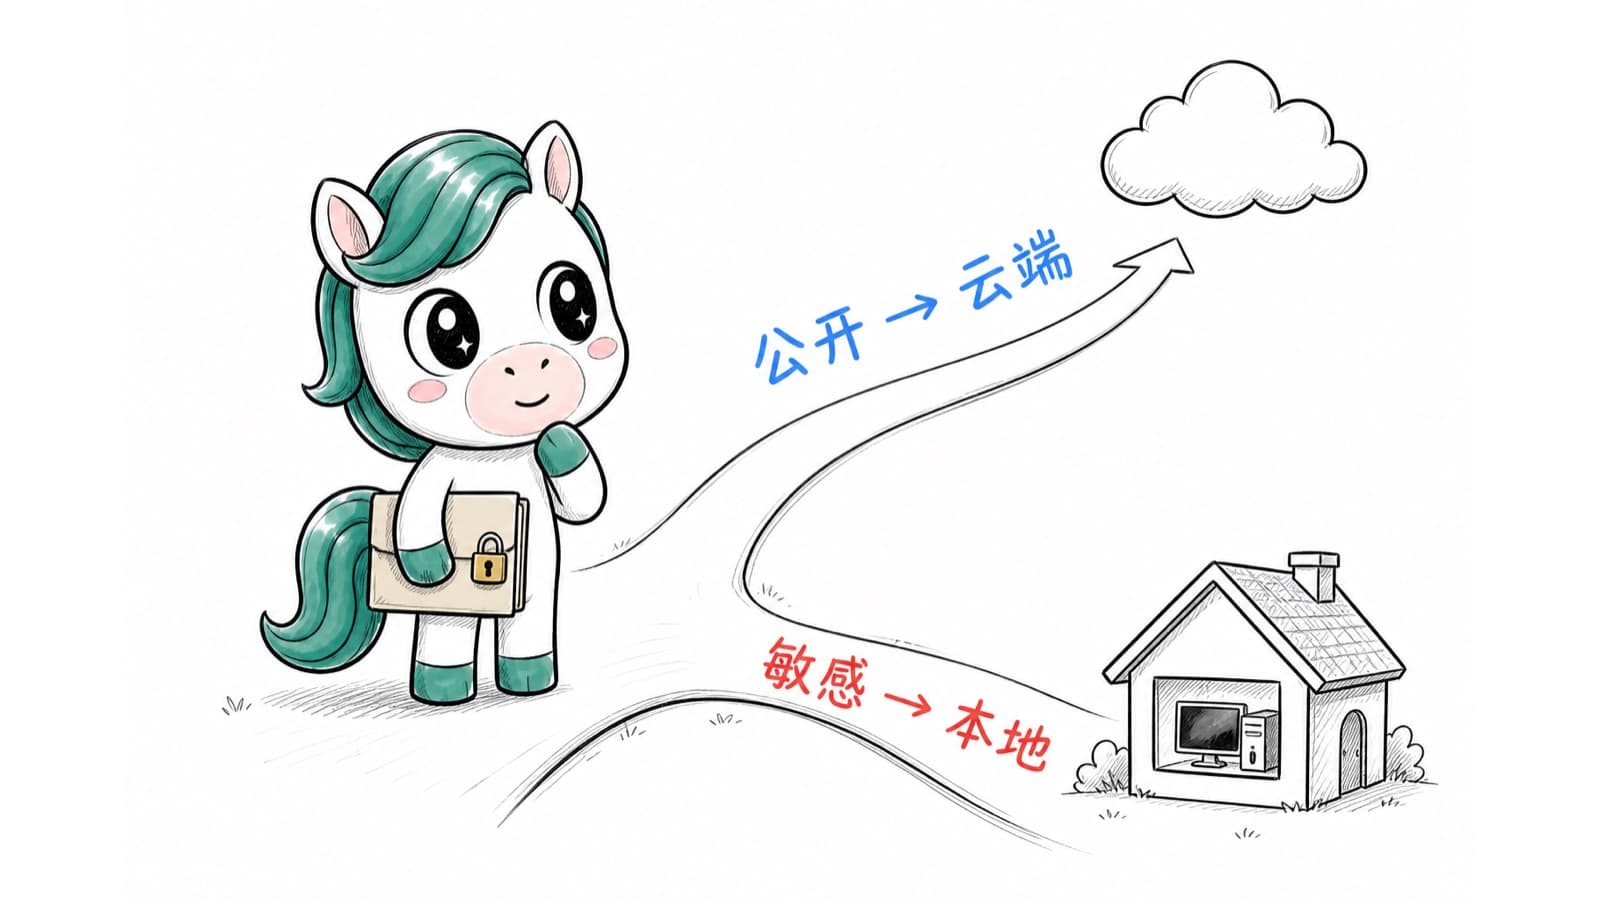
具体来说,KarmaBox 支持把实验记录、内部文档、未发表的手稿上传到自己设备上的知识库,AI 自动整理成可检索的资料库,提问时直接在本地查,不用每次把原文贴给外部服务。同一个界面里也可以接国产模型、国际模型和本地部署的模型,处理敏感数据时切到本地模型,查公开文献、改英文表达时再用云端的强模型,同一个工作流里分开走。它同样支持本地或私有部署,核心数据不出企业内网;还可以建多个分身分工,比如一个专门跟踪领域新论文,一个负责整理组内资料,配合定时任务按时汇总。
需要说明的是,本地跑模型对硬件有要求,具体能跑哪些模型、速度如何,部署前最好先按自己的机器和数据量确认一下。
今天就能做的几件小事
不管你用不用本地部署,下面这些习惯都值得养成。都不难,难的是坚持。
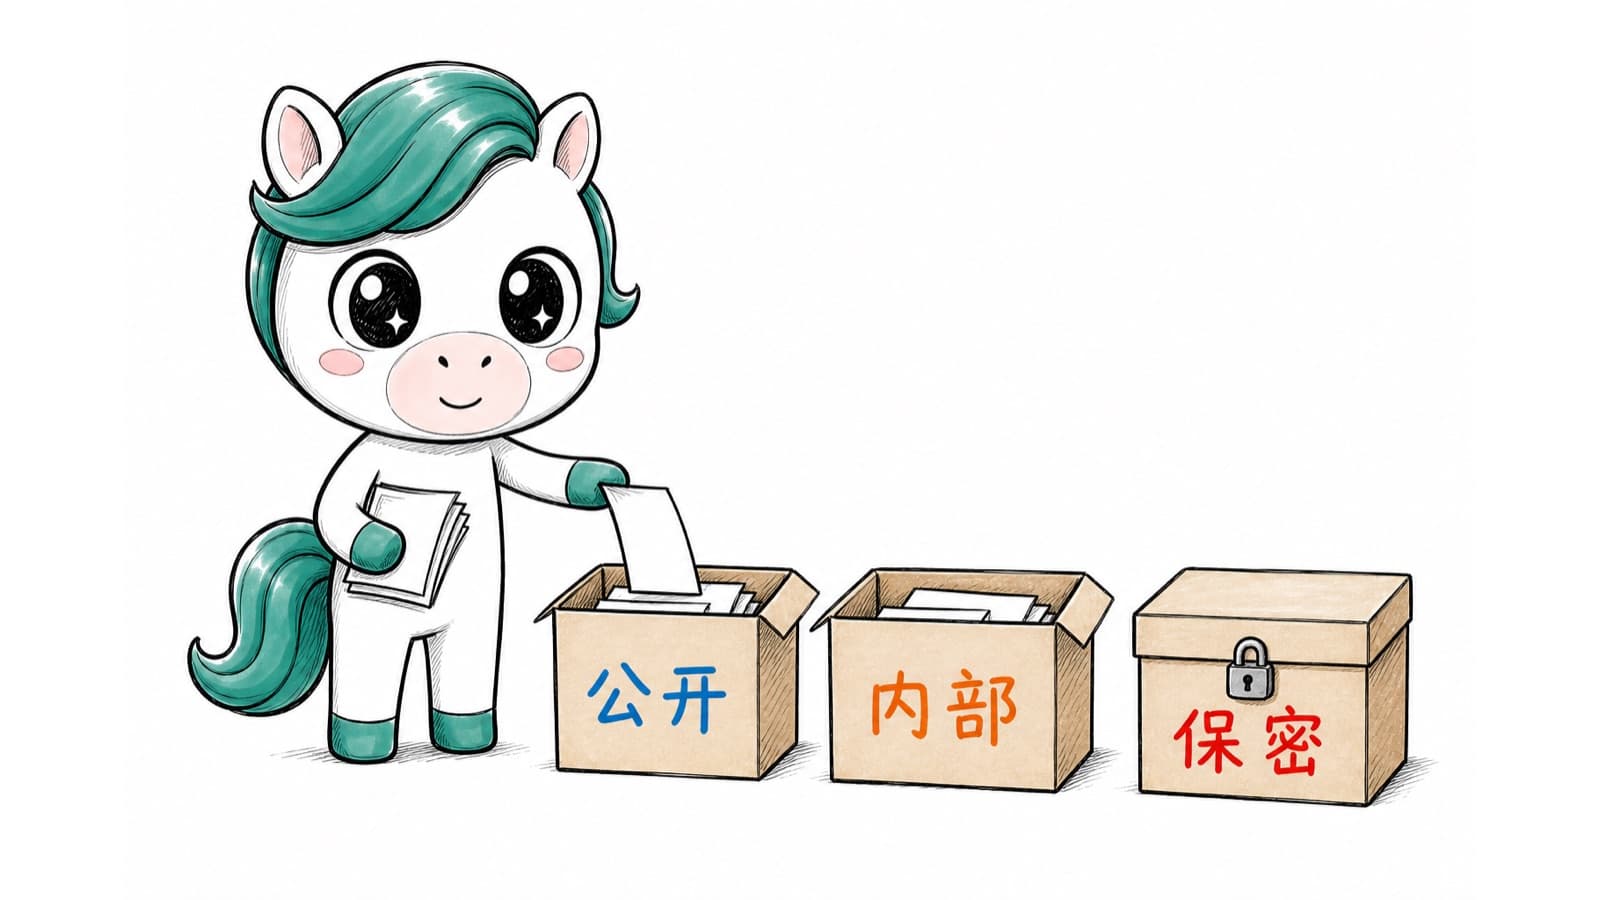
先给手上的数据分个级。我自己的分法很粗,就三档。公开的东西随便用;内部的东西用之前想一想,最好用企业版或者本地;没发表的、涉及他人隐私的、签了保密协议的,原则上不进任何外部 AI。分得粗没关系,关键是点发送之前脑子里有这根弦。
要用外部工具时,学学劳伦蒂诺的办法。基因名、样本编号、客户名称、项目代号,统统先换成通用标签。代码里的变量名也别忘了,很多人只改了正文,变量名里还写着实验物种和处理条件。
花十分钟把常用 AI 工具的设置翻一遍。训练开关在哪,对话记录保留多久,能不能一键删除,团队版和个人版有什么区别。条款看不懂的地方,记下来去问客服,要个书面回复。
再一个容易被忽略的,是给自己的想法留时间戳。撞车这种事,最后往往要比谁能证明自己更早。实验记录本按日期写,关键思路发一封邮件给自己,代码按时提交到版本库,合适的时候考虑先发预印本。这些记录平时没用,真到了说不清的时候,就是你的底气。
如果你在审稿或者评基金,别人的稿子和申请书不要上传 AI,哪怕只是让它帮你理一下逻辑。惠康基金会已经明令禁止了,其他机构跟进只是时间问题。
几个常被问到的问题
1. 问:未发表的研究数据上传到 AI,一定会被拿去训练吗?
答:不一定。这取决于你用的是哪个产品、哪个版本,以及你的隐私设置。很多服务允许关闭训练,企业版通常默认不训练。但不训练不等于不存储,具体保留多久、谁能访问,要看服务条款。
2. 问:关掉「用我的数据改进模型」,是不是就安全了?
答:能降低一部分风险,但不是全部。Evitable 创始人大卫·克鲁格就指出,退出训练也未必能确保信息安全。存储、日志、人工审核、司法调取、系统被攻破,这些都不在训练开关的管辖范围里。
3. 问:ART 这件事,到底是不是 AI 用了别人的数据?
答:目前没有结论。哥本哈根大学的博士生梅斯特说团队的工作和 Claude 的发现明显重合,但他本人也表示没有证据证明公司用了他们的成果。Anthropic 否认知情,并表示 Claude 没有用用户对话训练。
4. 问:AI 会不会抢走科研成果?
答:有两种可能要分开看。一种是数据泄露,可以靠管好数据来防;另一种是 AI 仅凭公开文献先找到答案,这更像是竞争,防不住,只能靠更早记录、更快发表、更好地提出问题。
5. 问:小团队有必要搞本地部署吗?
答:看数据。如果主要处理公开资料,用好云端工具加上脱敏就够了。如果手上长期有未发表数据、专利前的技术方案或者客户隐私,本地或私有部署值得认真算一笔账,硬件和维护成本要算进去。
写在最后
ART 的争议大概率会不了了之,就像过去很多「撞车」一样。可它留下的问题不会消失。AI 越能干,我们越愿意把东西交给它,交出去的东西也就越值钱。
想清楚哪些可以交、哪些只能留在自己手里,这个判断以后会是做研究、做生意的基本功。今晚下班前,不妨把你最近上传过的文件翻一遍,看看有没有哪一份其实不该发出去。
先问清楚它去哪,再决定给不给。