先把立场说清楚:这篇文章前面大半在讲一个普通人也会遇到的问题——你和 AI 的对话到底去哪了。后半段会讲到我们自己的产品 KarmaBox,那部分会单独标出来,属于产品介绍,不是第三方评测。文中引用别家公司的说法,均出自对方公开资料,请按「厂商自述」理解。
先讲个你可能也干过的事。
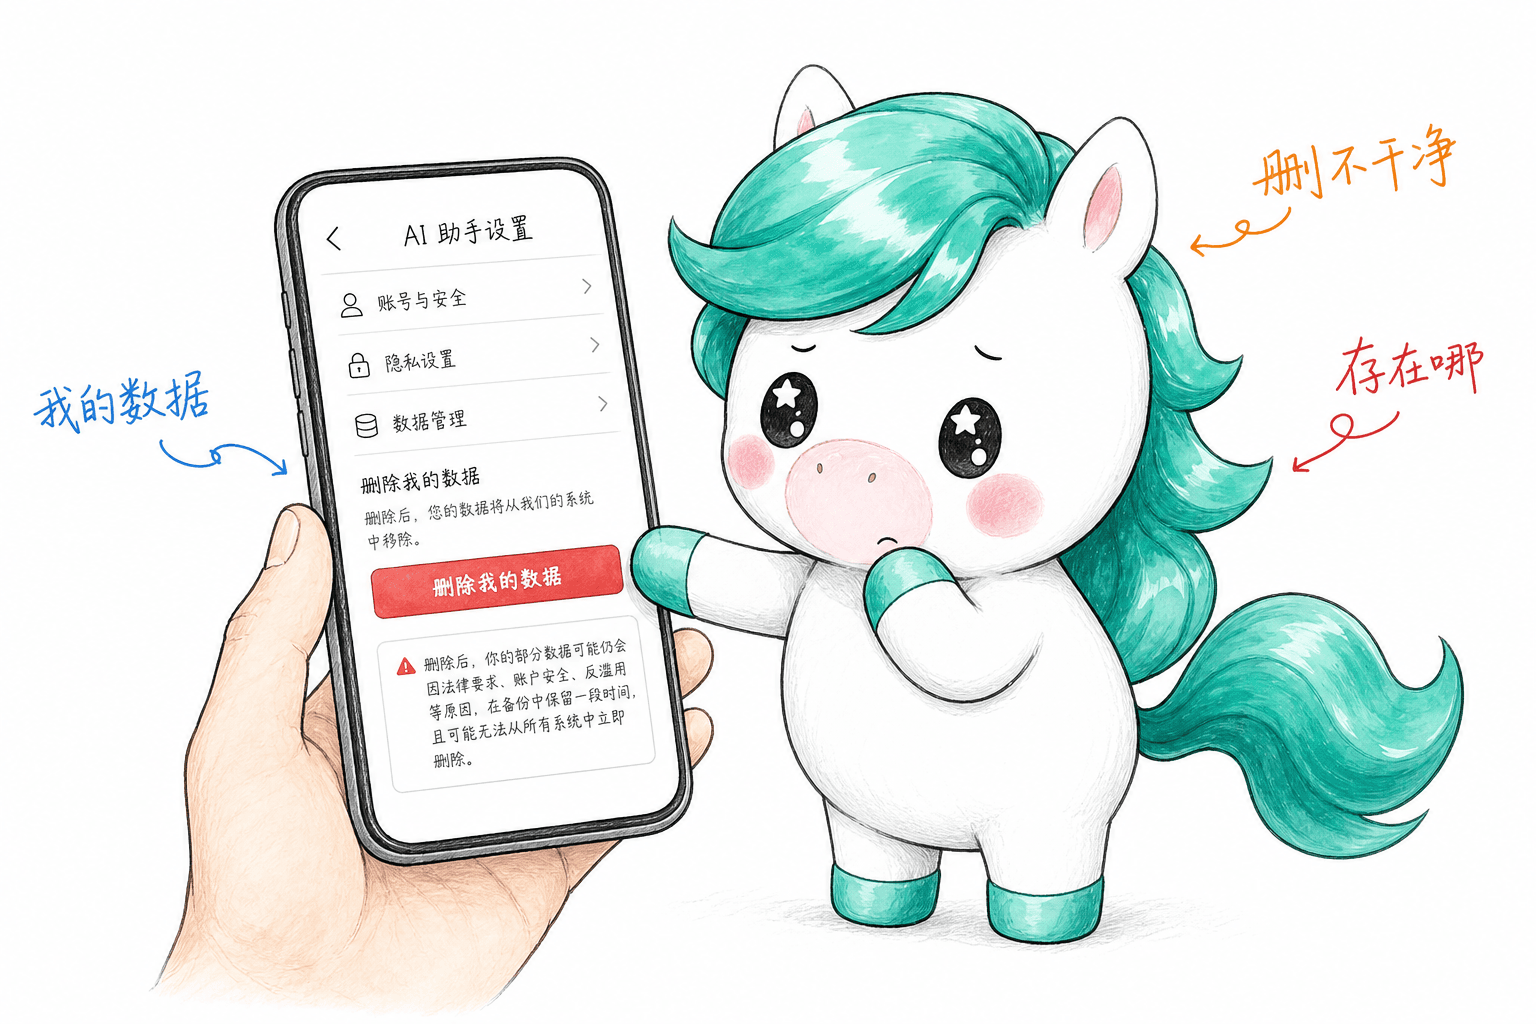
前阵子,我一个同事想退掉一个用了一年的 AI 助手。她点进设置,找「删除我的数据」,翻了四层菜单,最后看到一行小字:删除账号后,部分对话数据可能因模型改进和合规要求继续保留一段时间。
她盯着那句话看了半天,问我:那我这一年跟它讲的东西,到底还在不在?
我没法替她回答。因为答案不在她手里,在对方的服务器上。
这不是她一个人的处境。2026 年,几乎每个认真用 AI 的人,都在不知不觉中把一堆原本很私密的东西,交给了一个自己看不见、管不着的地方——你的文风、你客户的名字、你没对外说过的报价、你半夜问它的那些乱七八糟的问题。用得越顺手,交出去的越多。
这篇文章,就想把这件被绕过去的事讲清楚:你和 AI 说的每句话,到底存在谁的服务器上?这件事为什么突然变得重要?普通人和小团队又能怎么办?读完你会得到三样东西:一套判断数据该放哪的方法、三个最常见误解的破解、以及一份今天就能照做的自查清单。
一、「主权 AI」这个词,最近为什么突然火了
如果你最近刷到「主权 AI」这个词,不奇怪。
2026 年 10 月 23 日,360 创始人周鸿祎在谈 DeepSeek 开源时,把一个原本很技术的话题,讲成了一句普通老板都听得懂的话。他的大意是:很多企业现在用的 AI,是「租来的」——模型、算力、平台都攥在别人手里,就像一个你家用的水龙头,阀门却在别人手上。对方要涨价,你得接受;对方哪天把服务改了、把你依赖的那个模型下线了,你的活儿可能就停了。
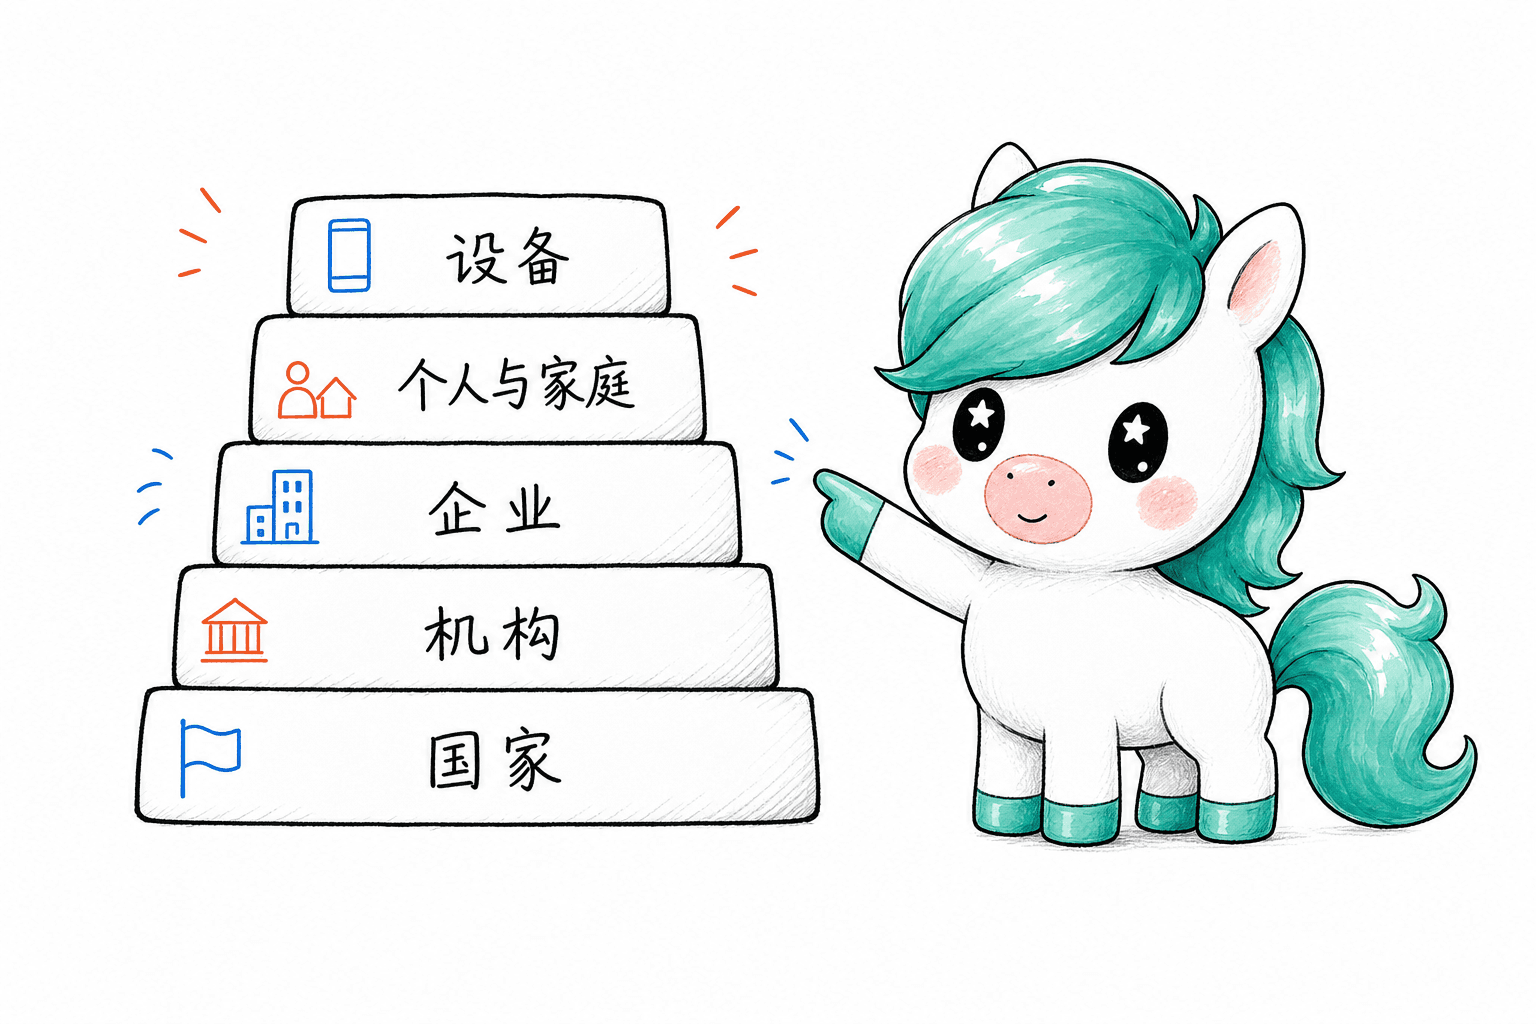
他还提了一个我觉得特别好记的分法,把「主权 AI」拆成五个层级:国家、机构、企业、个人和家庭、设备。换句话说,「数据和 AI 的控制权到底在谁手里」这个问题,从一个国家一路问到你手里那台手机,每一层都成立。
这话之所以能火,不是因为它新。本地部署、数据不出境这些概念,技术圈念叨好几年了。它火,是因为它第一次把一个抽象的技术选择,翻译成了一个普通人的焦虑:我辛辛苦苦教会它的那些东西,到底归不归我?
而且这不只是中国的讨论。2026 年,海外也在集体转向。过去十年那句「上云优先」(Cloud-First),正在被一句「主权优先」(Sovereign-First)替换。有一个细节值得一提:很多人以为「数据存在哪个国家」就等于安全了,但海外的隐私研究者反复提醒一个区别——数据放在哪(data residency)和数据归谁管(data sovereignty)是两回事。一家美国公司的云,哪怕把你的数据库放在法兰克福,它的母公司依然受美国法律管辖,一纸传票就能调走放在海外的数据。换句话说,「存在本地」如果不等于「你能管」,那只是一张纸面上的保证。
说到这,你大概能感觉到:这不是一个「要不要赶时髦」的问题,而是一个早晚得想明白的问题。
二、别被术语吓到:主权 AI 说白了就三件事
「主权 AI」听着高大上,其实落到实处,就是三个特别朴素的问题。你不用懂任何技术,照着问就行。
问题一:数据在哪?
你发给 AI 的文件、聊天记录、客户资料,处理完之后去了哪里?没有主权的版本,是全部上传到对方服务器,按对方的隐私政策处理,你能做的只是勾一个「不要用我的数据训练」然后祈祷对方真做到。有主权的版本,是敏感的东西默认就留在你自己的设备或私有云里,根本不进对方的管道。把「请别保存这段」写进提示词,那是一个愿望;让数据在物理上就没离开你的电脑,那才是一个保证。
举个场景:一个做财税代账的小工作室,手里是几十家客户的银行流水和报表。用在线 AI 帮忙整理,效率高了,但这些流水到底传到哪台服务器、留多久,老板心里其实没底。真出一次事,丢的不是效率,是客户的信任和自己的饭碗。
问题二:模型归谁?
你能不能用自己的数据去调教这个 AI,调完之后能不能留住成果?没有主权的版本,你被绑在某一家的路线图上——它更新你得跟着变,它下线某个模型你只能换,它涨价你只能认。有主权的版本,你能在云端模型、开放权重模型、自己的 GPU 之间来回切换,而且上面搭起来的东西原地不动。
这里有个容易被忽略的点:真正值钱的,往往不是模型本身,而是模型学到的关于你的那部分。举个场景:一个自媒体作者,花了三个月把 AI 调成了自己的文风——知道他爱用短句、讨厌某些套话、每篇结尾要留个钩子。如果有一天平台涨价或下线,这份「懂他」带不走,他等于重新招一个什么都不记得的新人。
问题三:算力听谁的?
这活儿到底跑在谁的机器上?没有主权的版本,是在别人机房的下拉菜单里选一个「区域」,用多少、快不快、限不限速都由对方说了算。有主权的版本,本地模式是「一等公民」,你在自己机器上跑的时候不被计量、不被限速、不占配额。
举个场景:一个法律团队要批量过一批合同,几百份一起上。用云端按量计费,一个月账单能吓人一跳,还得担心这些合同有没有被留痕;跑在自己机器上,电费之外几乎零成本,而且文件压根没出门。
三个问题,只要有一个你答成了「归我」,就已经比「全都上传然后祈祷」强。三个都答成「归我」,那就是完整的主权 AI。
三、三个最常见的误解,先替你破掉
聊主权 AI,绕不开三个几乎人人都会踩的误区。先讲清楚,能帮你省下不少冤枉钱。
误解一:「我把数据放在国内的云,就安全了。」这混淆了「驻留」和「主权」。数据放在哪个国家,解决的是「会不会跨境」;但「谁在运营这套系统、谁在法律上能要求它交数据」,是另一个问题。真正该确认的不是「你把我的东西放哪了」,而是「这东西到底听谁的」。
误解二:「要主权,就得把云全砍了、全搬本地。」这是最费钱的极端。最务实的做法从来是分层:日常不敏感的问题,继续用云端最强的模型,怎么方便怎么来;只有最要命的那一小撮核心资料,才值得搬回自己能管的地方。能在两者之间自由切换,本身就是主权的一部分。那种「要么全云、要么全本地」的二选一,是个假命题。
误解三:「本地 AI 一定很难用,得养个工程师。」这是三年前的印象了。今天的工具,用大白话把活儿描述清楚就能跑,不用写代码;开放权重的模型越来越能打,一台正经的机器就能起步。「搬回家」的技术代价,这一两年肉眼可见地往下掉。
四、为什么偏偏是现在?因为 AI 开始「记事」了
前两年的 AI,更像一个问完就忘的陌生人:你问一句它答一句,你关掉窗口它什么都不记得。记不住,自然也就没什么好担心的。
但 2026 年变了。现在的 AI 开始记事了。越来越多产品主打「记忆」:它记得你上次说过不喜欢某个词,记得你公司的汇报格式,记得你三个月前提过的那个项目。用起来真的贴心,但贴心的另一面是:它正在你看不见的地方,攒下一份关于你的档案。
周鸿祎在那次谈话里有个判断我很认同:当 AI 开始替企业干活,智能体积累下来的数据、知识、经验,正在成为一家企业「核心资产的边界」。翻译成大白话就是——你越依赖它,它脑子里关于你的东西就越值钱,也就越危险。
海外技术社区说得更直白:一个 AI 智能体每次工作,它的推理过程、调用了哪些工具、中间结果,全都被记在第三方服务器上。对很多人来说,这些过程记录比你打的那句话本身更敏感——合同、病历、源文件、检索日志,往往藏着比问题本身多得多的信息。
所以「现在才重要」的逻辑很简单:AI 越好用,你越多的真实生活和真实工作就从它身上流过去;而「不拥有这些记录」的代价,也就水涨船高。
五、一个真实的分水岭:从「聊天机器人」到「你雇的那个 AI」
要把主权落到实处,得先换个思路:你想拥有的,不是一次次的对话,而是一个持续存在的、属于你的 AI。
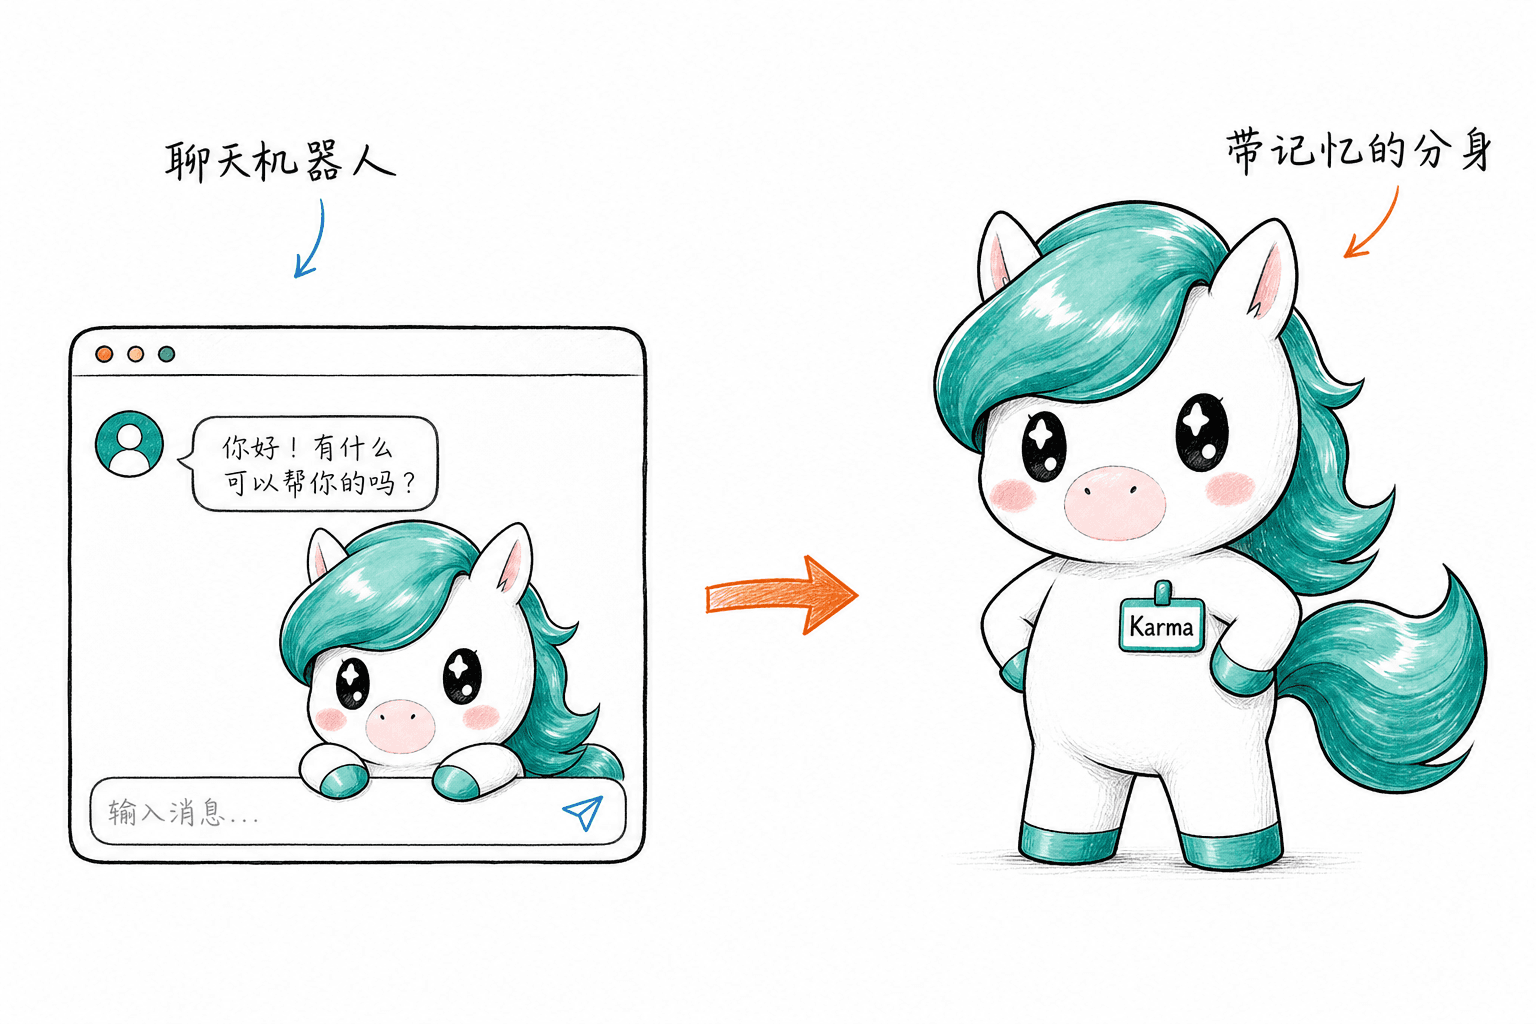
聊天机器人像一扇窗:你打字、它回答、你关掉,除了一段你大概永远不会再看的记录,什么都不留。AI 分身不一样——它是一个有名字、有职责、有记忆、有权限边界的「持续存在的工作者」。你给它一个角色,下次你再来,它还守着这个角色,连同它学到的一切。这种「持续」,才是值得拥有的东西。一个带记忆的 AI 分身,像个好员工那样攒价值:你之前的纠正,之后还在生效。
几个普通人就能用上的例子:内容分身,你给要点它按你风格起草几种格式的文案,发布前绝不自作主张;收件箱分身,盯着一个邮箱把要紧的挑出来、草拟回复,「发送」永远留给你;调研分身,盯一组信息源有变动就抓出来、按你定的节奏交短摘要;报表分身,把销售库存状态这类重复报表变成不用你催就送到手上的东西。
从「一个我对着聊的机器人」,到「一个我雇来的、带得走的分身」——这一步,才是从「租产出」真正走到「拥有一个工作者」。
💡 如何用 KarmaBox 实现?
以下是我们自己产品的介绍,不是第三方评测。
前面讲的三个问题——数据在哪、模型归谁、算力听谁的——KarmaBox 做的,就是让一个普通人或小团队,能把这三个答案都攥回自己手里。一句话说,KarmaBox 是一个面向个人和小团队的主权 AI 工作区。
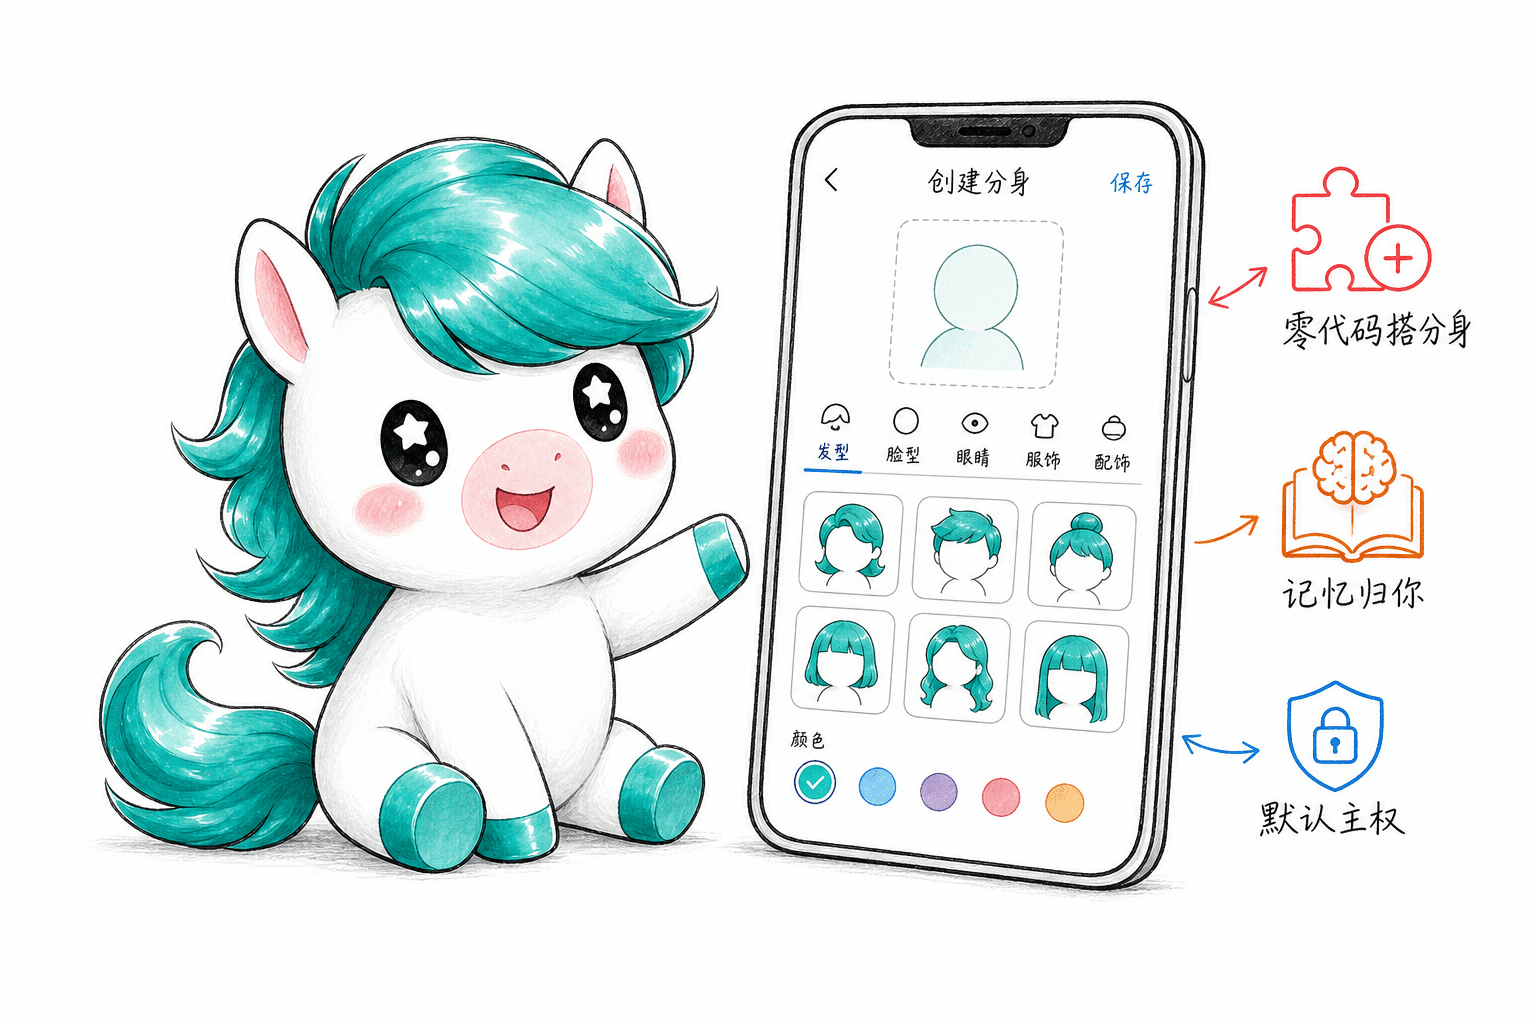
三大核心能力:零代码搭分身,还能组队——用大白话描述一个角色,五分钟你就有了第一个能干活的分身,不需要工程师。给几个分身不同职责,它们在同一个空间里协作——一个调研、一个起草、一个复核,上下文在它们之间流转,而不是你在四个互不相通的工具里复制粘贴。
记忆跟着分身走,而不是跟着模型走——而且归你:你能在云端模型、本地模型、自己的 GPU 之间切换,分身和它们的历史原封不动。本地知识库用气泡检索(BFS):把文档的每一小块当成一个「证据单元」,记得这块来自哪一章、哪张表、哪个时间点——所以分身给的答案能回去跟原文核对,而不是用几块「看着像对」的碎片拼出来的。
默认主权,控制权在你:文档和工作上下文默认留在你的设备或私有云里,不进训练管道。每个分身带一个签名的 did:wba 身份,别人能验证它是谁、能做什么。关键动作——发送、发布、花钱、删除——都要你点头确认,而且这道关卡落在服务端,不是靠提示词客气地请求模型。本地模式按 0 token 计算,没有用量上限。
立即体验:访问 karmaboxai.com,免费搭你的第一个分身。
六、不同的人,该怎么做?
主权 AI 不是一个「全有或全无」的开关。按你是谁,优先级差别很大。
如果你是个人用户:你大概率不需要立刻上机器。先养成一个习惯就够——不敏感的问题随便用云端最强的模型;真正私密的(财务、健康、没发表的作品),要么别喂,要么用能本地处理的方案。先把「分得清」做到,再谈「搬得动」。
如果你是小团队 / 创业公司:你的「核心资产」开始值钱了——客户名单、报价、还没签的合同、团队调教出来的工作流。建议走分层:日常上云,核心资料放一个你能锁门的本地/私有空间,并且确保「换模型不丢积累」。这一步现在零代码就能起步,不必等到招得起工程师。
如果你在受监管行业(医疗 / 金融 / 法律):主权对你不是选择题,是合规题。2026 年这些行业普遍面临更细的数据驻留和可审计要求——自动化决策的每一步都要留痕可查,而这只有在「日志存在你自己管得住的设施上」时才成立。对你来说,本地/私有不是加分项,是底线。
七、几个诚实的边界,先说在前面
一篇只会推销的文章没价值。主权 AI 这条路,有它真实的代价。
代价一:主权要你多担一点。拥有你的 AI,意味着你得为它多担一点责任——指向一个私有云、养一块 GPU、把知识库收拾清爽。「全都上传」那条默认路更省事,恰恰是因为那份重量(连同你的数据)由别人扛着。解法不是假装这份活儿会消失,而是把主权这条路做成「低摩擦」的那条。比起一年前,这道坎窄了很多,但没完全消失。
代价二:检索质量,仍取决于你喂进去什么。气泡检索能让一个文件被切开之后仍然读得懂,但它没法把一个乱糟糟的文件变干净,也没法把一个含糊的问题变精确。所以诚实的说法是「答案能跟原文对得上」,而不是「永远不会错」。但一个能告诉你「这句话出自哪」的分身,远比一个说不清来源的分身更值得信,也更容易被你纠正。
八、普通人现在能做的三件小事
第一,做一次「数据去哪了」的盘点。花十分钟找一找你常用 AI 的隐私政策和数据删除选项。你不一定要换工具,但你得知道自己把什么交出去了。
第二,把最敏感的那部分先搬回来。先挑出你最不想泄露的那类材料——客户资料、财务、没发布的作品——优先用能本地处理的方案。
第三,开始攒一个「带得走」的 AI。下次你认真调教一个 AI 助手之前,先问一句:如果有一天我要走,它学到的东西跟不跟我走?如果答案是「不跟」,那你攒的就不是资产,是别人的护城河。
常见问题
问:主权 AI 是不是就等于「把 AI 装在本地电脑上」?
答:不完全是。本地部署只是实现手段之一。主权的核心是「控制权在你」——数据在你能管的地方、模型你能换还留住积累、算力跑在你说了算的机器上。它可以是本地,也可以是你自己的私有云。
问:数据放在国内的云,是不是就有主权了?
答:那叫「数据驻留」,不等于「数据主权」。驻留解决的是数据存在哪个国家;主权问的是谁在运营、谁在法律上能调取它。两者是两回事。
问:主权 AI 是不是意味着要放弃云端最强的模型?
答:不用。最务实的做法是分层:日常不敏感的继续用云端最强的模型,只有核心资料那一小撮才搬回本地。能自由切换,本身就是主权的一部分。
问:本地跑 AI 是不是很贵、很难,一定得懂技术?
答:门槛比你想的低。零代码就能搭会干活的分身;真正的硬成本是显卡显存,按团队实际并发配机器即可。比起三年前,这件事简单太多了。
问:我把数据「删除」了,就真的没了吗?
答:看条款。很多服务写明「删除账号后,部分数据可能因模型改进或合规保留一段时间」。所以「在设置里点删除」是一个愿望;「数据根本没离开你的电脑」才是一个保证。
问:AI 的「记忆」功能,到底记了我什么?
答:通常有三层:当前对话的上下文、跨对话主动记住的事实(偏好、习惯)、以及最容易被忽略的「过程日志」(推理步骤、调用的工具、读过的文件)。第三层往往比你打的那句话更敏感。
问:个人用户也需要操心主权 AI 吗?
答:看你喂了什么。只是查菜谱、写无关痛痒的文案,不必操心;但如果你把财务、健康、没发表的作品交给它,就值得认真对待。
结语:别再把你 AI 的记忆,租在别人家里
回到开头我同事那个问题——「我这一年跟它讲的东西,到底还在不在?」真正扎心的不是答案是「在」还是「不在」,而是这个问题她自己答不了。一个东西,你最在意、却最管不着,那它从一开始就不算你的。
主权 AI 不是一个更大的模型,也不是一句口号。它只是把一个被绕过去很久的常识重新摆上桌:AI 学到的关于你的一切,应该归你。数据在你能管的地方,模型可以换而积累还在,算力跑在你说了算的机器上——这三件事凑齐,你拥有的才是一个真正属于你的 AI。
你准备好,把你 AI 的记忆搬回家了吗?想亲手试试,访问 karmaboxai.com,五分钟搭一个只听你的分身。
参考来源:周鸿祎谈 DeepSeek 开源、「主权 AI」五级框架与「租来的 AI」之喻,澎湃新闻·10% 公司,2026-10-23;同一事件报道,新浪财经,2026-10-23;同一事件报道,网易科技,2026-10;「数据驻留」与「数据主权」区别、CLOUD Act 可调取境外数据的论述,属海外行业博客观点(safeguard.sh、activepieces.com,2026),仅供参考。