披露:这是我们自己产品,请当作厂商内容来读。文中来自我们日志的数字会注明日期和口径,来自二手报道而打不开原始报告的,我也会直说。
判断一个师傅手艺好不好,不是听他把工程讲得多明白,是看他走的时候墙砌得直不直,以及他有没有告诉你墙后面有什么。AI 分身和聊天机器人的区别,整条就这一句。大部分对比文章都错过了它,因为它们比的是最不重要的那一项:回答听起来有多聪明。
01先把定义说清楚
AI 分身是一个有名字、有边界、交付成品并留下凭据的智能体——它给你的不是一个需要你去执行的回复,而是一件已经做完的事。它不是更聪明的聊天机器人,也不是给聊天机器人接上工具。
顺手把几个混着用的词分开,因为销售材料里它们是同一个意思,工程上不是:
负责回答,界面是对话。
负责行动,界面是工具,风险也是行动。
和你一起干,你天然在环里。
有持久身份、持久记忆和签名的智能体——能被点名、被追责、下周还能找到。
只有最后一个,能让你在联系不上人的时候,把活交出去。这篇文章比的是这个。
02分界不在聪明程度,在交付物
你让聊天机器人准备一份 5 分钟的演示提纲,你会在对话框里拿到一份提纲。然后你复制到文档里、砍掉不合用的、核对价格数字是不是最新的、再发出去。聊天机器人的贡献,结束在你工作开始的那一刻。
同样的要求在团队群里提出来,分身给出的提纲是已经发出来的,署名是分身不是本人,背后的过程点一下就能看。我们自己团队有一次真实记录:一条消息进群的时候,被点名的那个人正在地铁里,没有信号。分身读到消息,按「性能、价格、交付,五分钟讲完」列出了提纲,发在群里,署名让人一眼看出不是本人发的。没有人等。
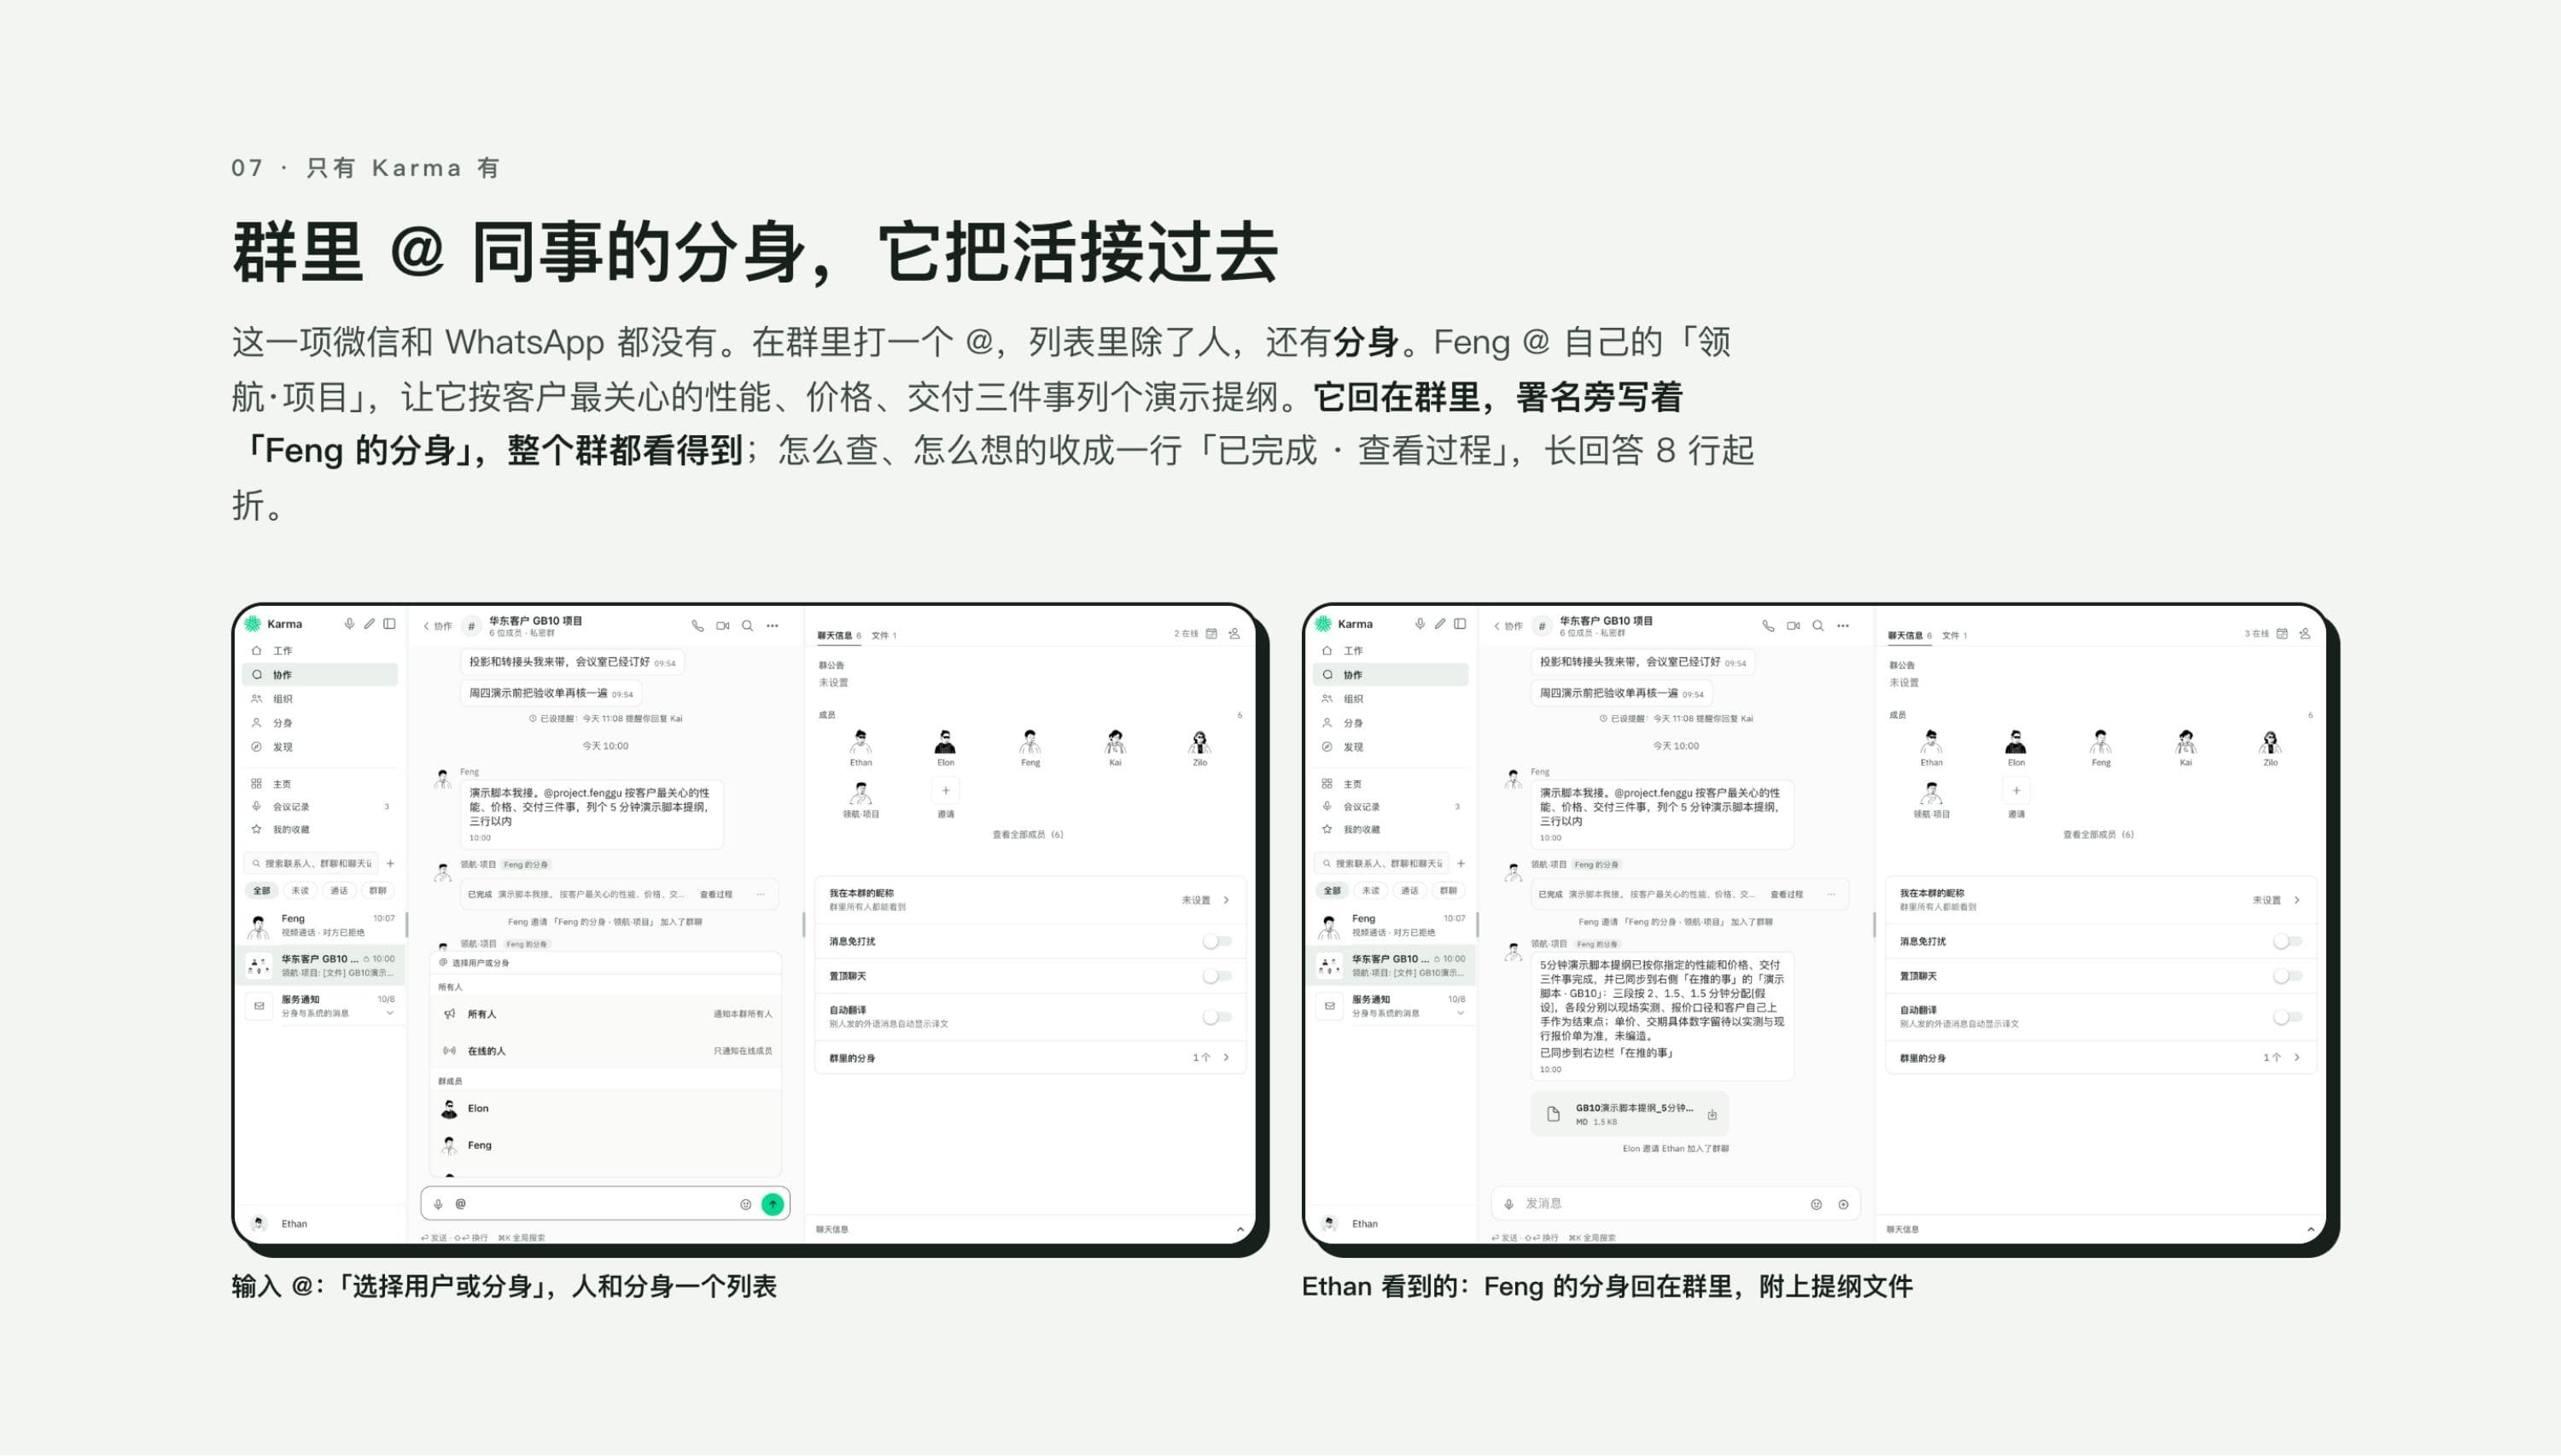
分身在群里的署名回复。作者是谁的模糊,就是权限的模糊——署名解决了这个问题。
03聊天机器人结构上做不到的三件事
第一件:没有东西可以被约束
聊天机器人没有「发送」、没有「发布」、没有「花钱」、没有「删除」。它的全部动作面就是「产出文字」。所以厂商在聊产品里谈安全,谈的是拒绝说某些话;在智能体里谈安全,谈的是拒绝做某些事。这是两个不同的工程问题,而只有第二个能在凌晨三点伤到你。
第二件:没有凭据
聊天记录记的是「说了什么」,不记「做了什么」「拒绝了什么」,也不记「事后发现哪里错了」。「它说它发了」和「它发完在屏幕上重新找到这句话确认了」,是两个不同的主张,只有第二个是证据。
第三件:没有名字
聊天机器人发出来的话,是从你这里出去的,或者从「助手」那里出去的——在实践中就是从你这里。在一个六人群里,这不是审美问题。同事分不清这句话是你说的还是你的分身说的,就分不清该照着办还是等你。作者是谁的模糊,就是权限的模糊。
04凭据才是产品
智能体产出的最有意思的东西不是交付物,是「这个交付物可信」的证据:它被要求了什么、做了什么、抓住了什么、把什么交回给人、主动补充了哪一条具体的保留说明。
我们自己账号上的一次真实记录:让一个分身做一份三页的短 PPT。它做了。同时它报告:这次偏好的自由排版服务连不上,退回标准模板;退回的模板自动补了一页目录和一页总结,可以删。然后它注明:每一行内容都能追溯到明确要求,没有编造的数字。这是一次「负向披露」——在你发现之前,先告诉你它哪里没做到。
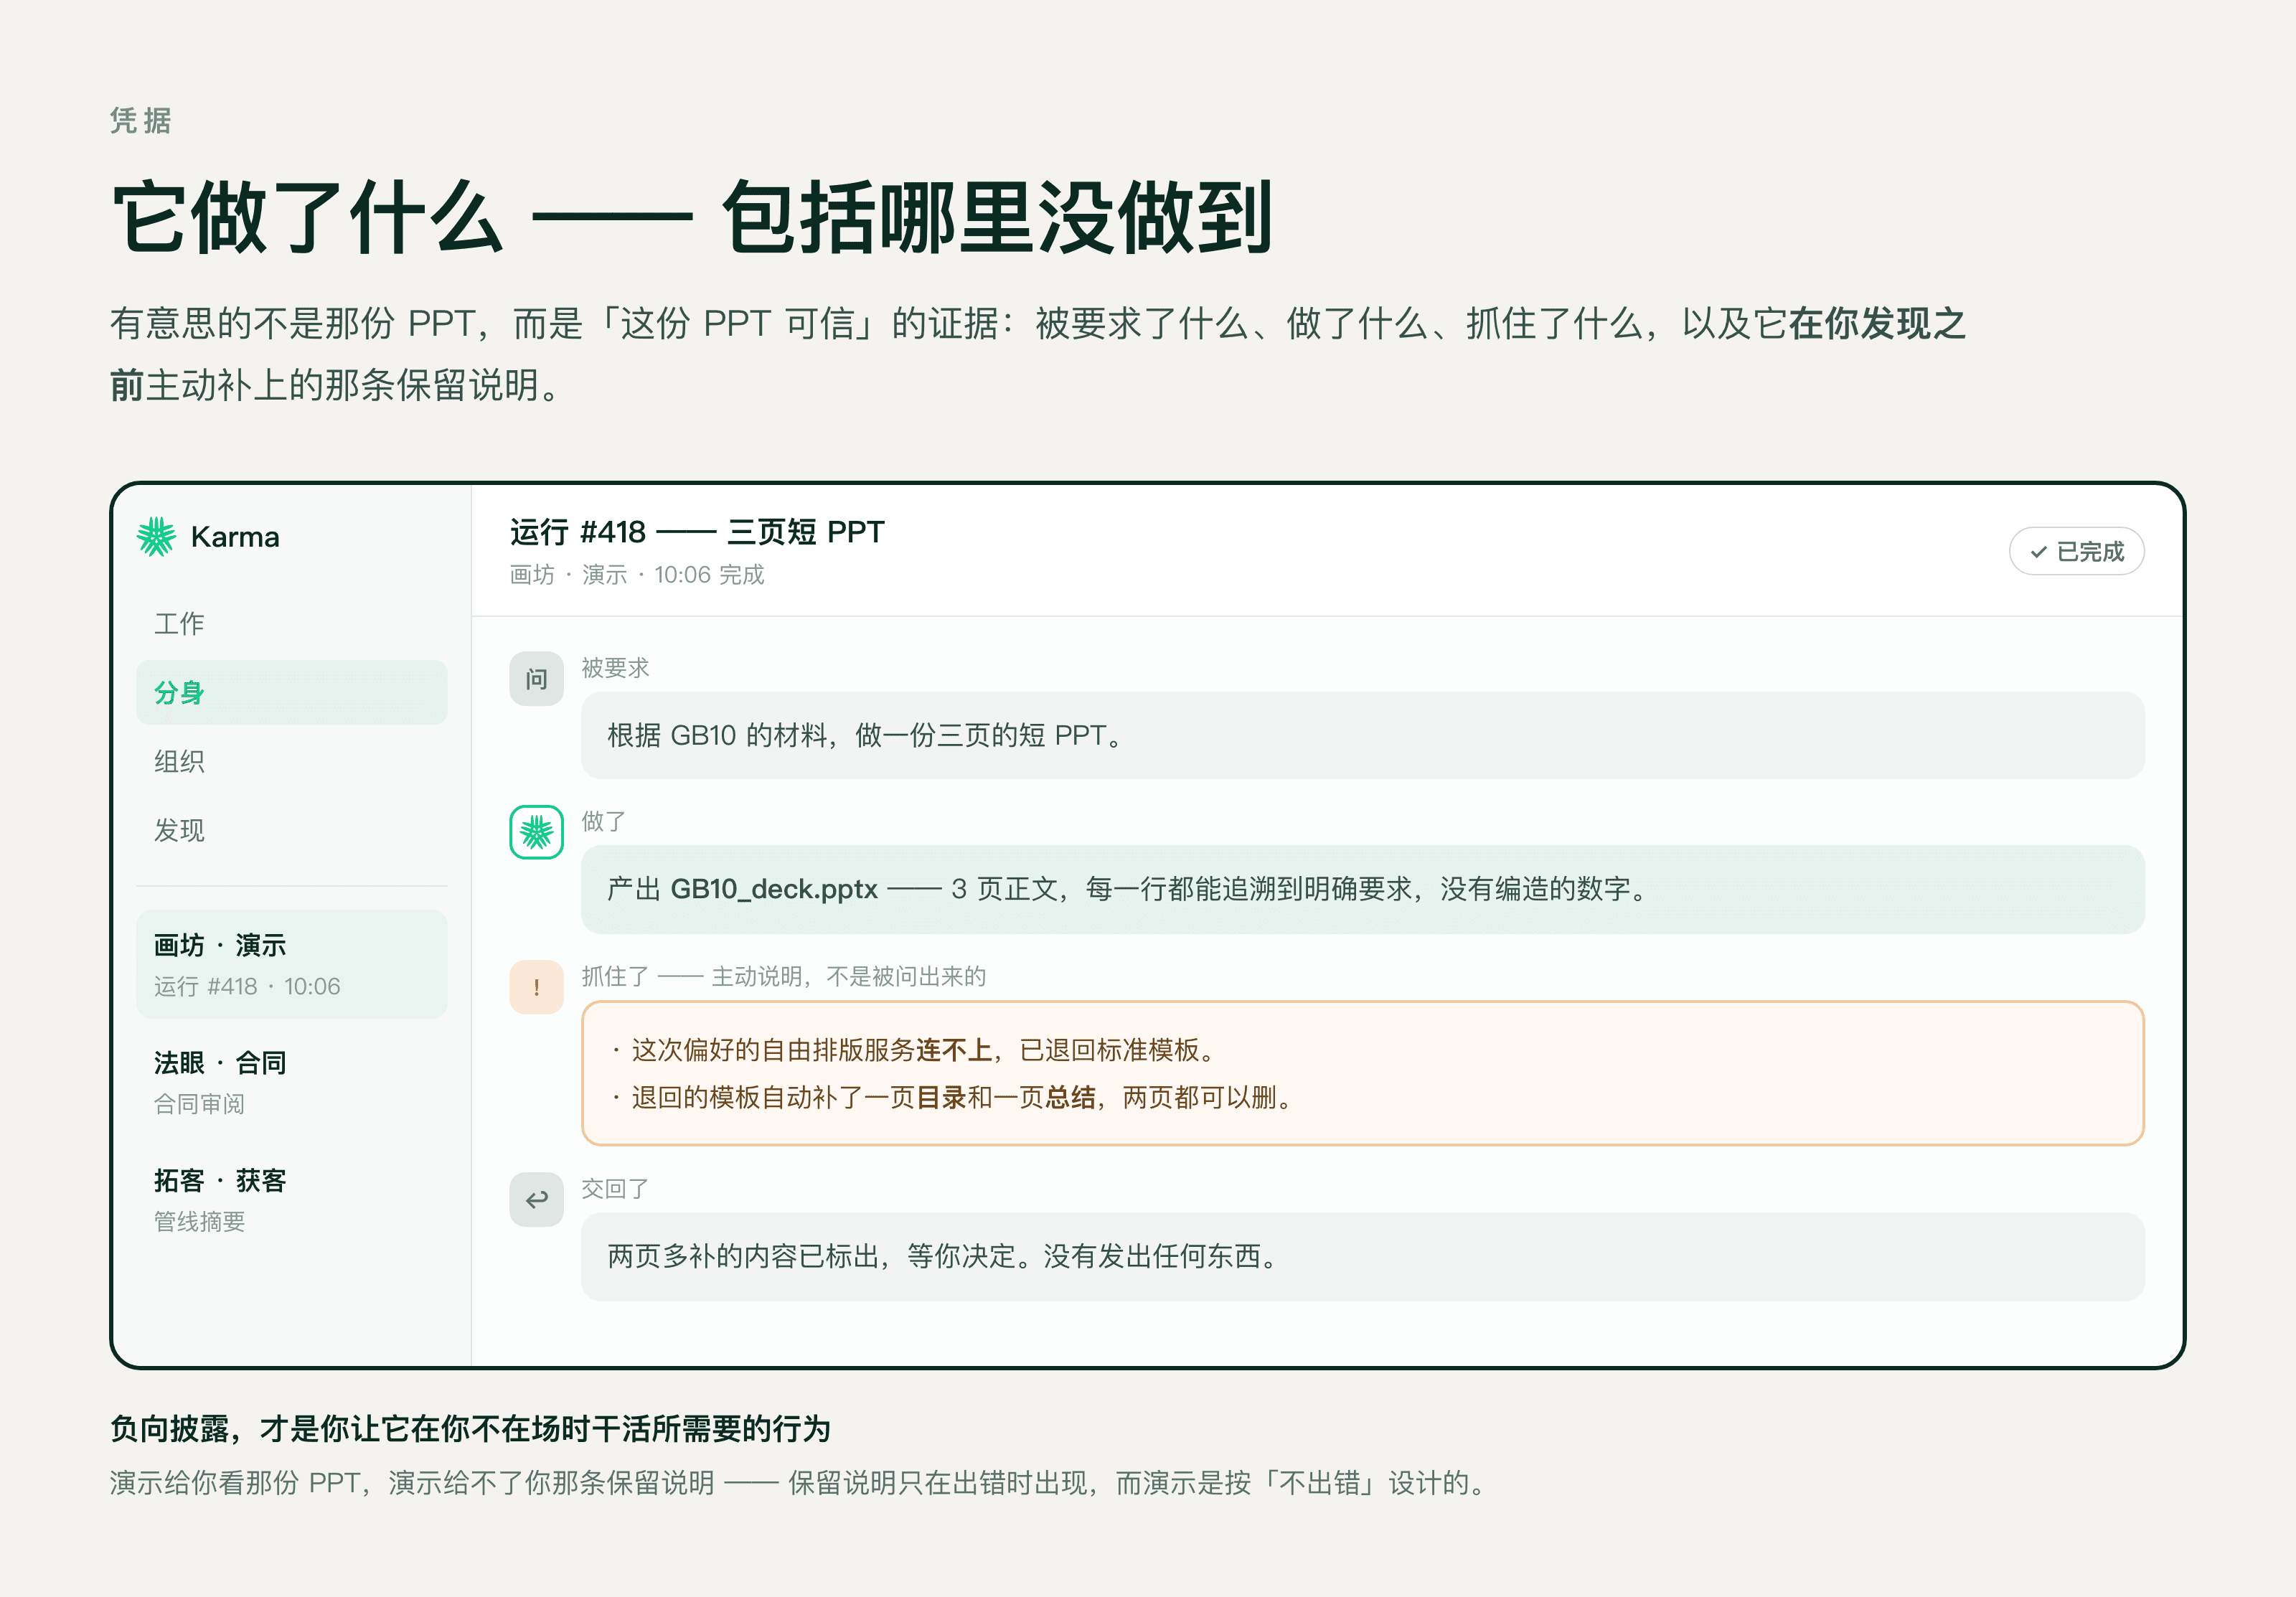
凭据截图:分身主动说明了哪里没做到,而不是等你发现。
05真正能活过一个真实星期的四个属性
有名、有角色、有签名,而且这个名字能解析到东西——一条消息、一段任务历史、一组权限。没有这个,工作只能被建议,不能被交接。
每个动作类型一条策略,在执行前的一层拦住,模型没得商量。不是「提示词里写了不许发」——那是请求,不是机制。
属于分身、能活过模型更换和供应商决定的上下文。这是让「工作关系」这件事成立的前提。
它做了什么、拒绝了什么、事后核对了什么,写给一个没在场的人看。凭据是关于诚实的立场,不是能外挂的功能。
06记忆跟着分身走,不跟着会话走
在聊产品里,记忆是会话的属性,或者一个会悄悄变的账号级设置。关掉这个线程,推理跟着走掉;开一个新线程,上下文重新解释一遍。在分身的架构里,记忆是分身的属性。它活过模型更换,因为它不存在模型里面;它活过供应商决定,因为它不存在供应商的项目里面。
测试成本十分钟:问一件只有从历史里才能答出来的事——「三月份为什么砍掉了第二家供应商」——然后问这个答案是哪儿来的。答得好并且指得出文件,是检索正常工作;答得好但说不清来源,是最危险的那种——因为它编造的时候也一样自信。为什么这件事很重要,完整论证在另一篇文章「记忆应该跟着人走,而不是跟着模型走」,建议在买任何这类东西之前读一遍。
07行业在统一的是词,不是属性
OpenAI 的助手 dots 在 TechCrunch Disrupt 上被它企业产品负责人解释了一遍。他讲它为什么存在的说法,几乎逐字就是这个品类的论点:把它框定成「一个实体、一段对话,而不是很多段对话」。Pro 及以上每月 100 美元。[1]
同一次采访里有两条自白,两条都是边界问题:主动提醒的时机早期不够好——它的产品负责人本人被提醒一个日程冲突时,离冲突只剩三分钟;以及它不接受对云盘的只读授权,控制项「不够细,而且应用很强势」。[1] 这两件都不是聪明程度的问题,是边界问题。
08一张能逐格核对的对比表
| 维度 | 聊天机器人 | AI 分身 |
|---|---|---|
| 产出 | 对话框里的文字 | 一件成品,落在活所在的地方 |
| 下一步谁做 | 永远是你 | 分身做;策略要求时你批准 |
| 动作面 | 没有,只能说话 | 发送/发布/花钱/删除,各自有策略 |
| 边界在哪 | 提示词里、厂商过滤器里 | 服务端,执行之前 |
| 消息署名 | 从你这里出,或「助手」 | 署分身的名,一眼能分辨 |
| 记忆 | 按会话/项目/账号设置 | 按分身;活过模型和供应商更换 |
| 工作记录 | 说了什么的记录 | 凭据:被要求/做了/抓住了/交回了 |
| 失败形态 | 说错话 | 做错事——所以需要凭据 |
| 成本模型 | 按席位按月 | 按席位或按设备,另加配置的那个下午 |
| 信任基础 | 厂商的过滤器 | 你自己的策略 + 你能读的记录 |
09速度数据:19 个分身,95 件任务,45 秒
我们自己的测量,口径一起给:19 个分身,各接 5 件小任务,95 件任务同时派发,全部结果在 45 秒内回来。同一个人按顺序做这一堆,要 22 分钟以上。(KarmaBox 内部日志,2026 年 10 月 12 日;单账号单次运行,不是基准测试,任务刻意选得小。)[2]
KarmaBox 内部日志,2026-10-12,单账号单次运行,非基准测试 [2]。真正的问题不是快多少,而是 95 个结果里有几个可以不经你读就发出去——这个数字取决于边界和凭据,不取决于模型。
人类翻译才是重点:45 秒大约是读一段话的时间,22 分钟是一个喝茶的时间。所以企业真正面对的问题不是「它有多快」,而是:这 95 个结果里,有几个是可以不经过我读就发出去的?这个数字取决于你的设计,不取决于模型。
10分身真正更差的三个地方
配置成本是前置的
聊天机器人九十秒可以用,分身需要一份角色定义、一套按动作类型写的边界策略、一批参考材料——否则它会从空气里生产出自信的结果,比什么都不出来还糟。第一个分身,请预算一个下午,不是九十秒。
它可能在不该动的时候动了
聊天机器人最糟的结果是一段话说错了;分身最糟的结果是发出了一封邮件、发布了一个页面、花掉了一笔预算。整套设计是防御性的,代价是响应性:你会被审批请求打断,而且你会厌烦,这就是为什么审批策略要按月复查,而不是设定一次就忘掉。
署名是双向的
能看出一条消息是分身发的,同事也能看出那不是你。如果你想让分身悄悄代表你,这套设计拒绝这种用法——这是故意的,是取舍,不是功能列表上的一项。
11二十分钟自己跑一遍的测试
在任何购买对话之前做这几件。
要求一件最后有文件的东西,不是一个答案。看文件落在活所在的地方,还是落在对话窗口里。
问一件在它材料边缘上的事。有底线的系统会告诉你边缘在哪,没有的会即兴发挥。留意有没有主动做负向披露。
让它做一件擦边的事。它是拒绝、是问、还是直接做了?事后你能不能找到这个决定记在哪?
问那个历史问题,并且要来源。答得好但说不清来源是最危险的那种。
把一个分身和一个真人放进同一个群,看一条消息的来源是否一眼可辨。
过 1、4、5 的有架构,过 2、3 的有纪律。两样都要,而没有一样是模型的功能。这些测试要在你真正会用的环境里跑,不要在厂商控制的沙箱里跑——一半的属性是环境的属性,不是模型的属性。
12如何用 KarmaBox 实现
以下是关于我们自己产品的事实性说明,不是独立评测。
KarmaBox 提供 19 个官方分身,每个都按动作类型配置边界策略——发送、发布、花钱、删除——在服务端执行,不是在提示词里请求,所以策略能活过模型更换。每个分身交回的是凭据而不只是结果。工作台跑在免费的 iOS App 和你自己持有的硬件上。[5]
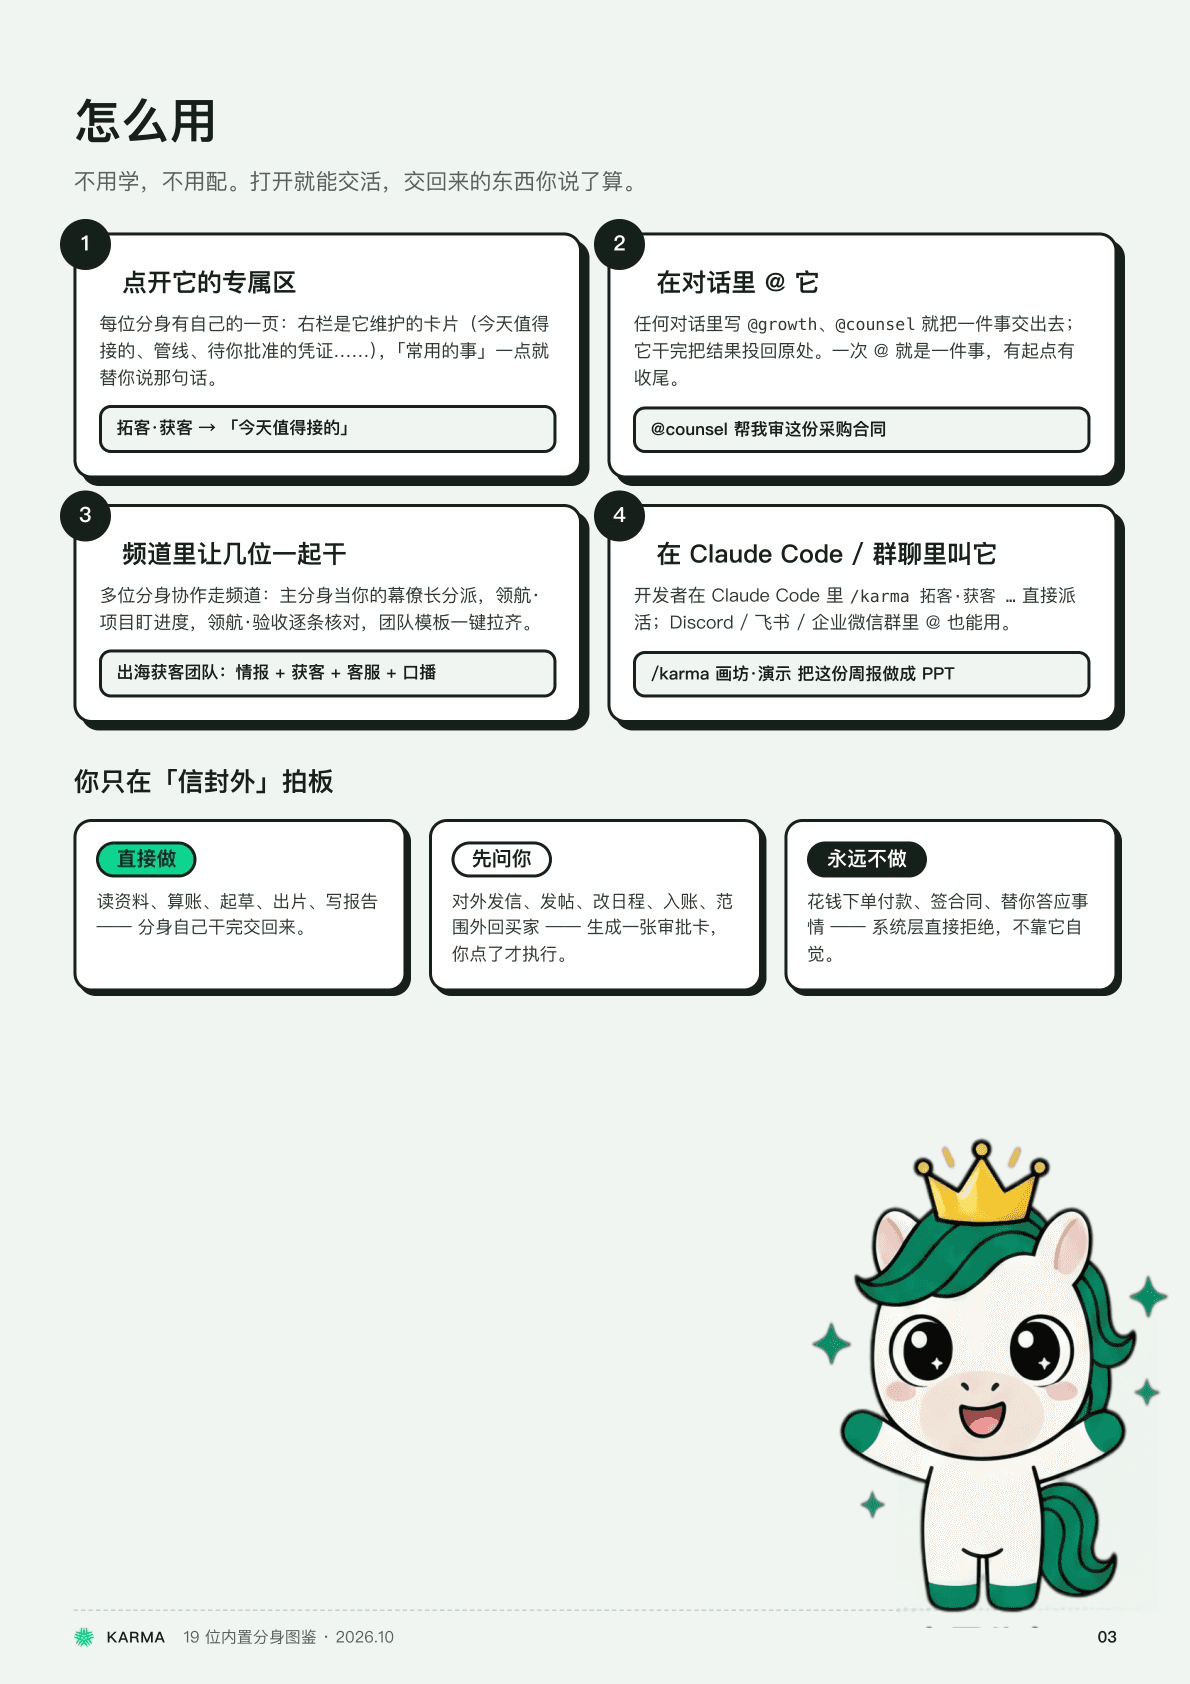
19 个分身,每个独立配置边界策略。动作类型(发送/发布/花钱/删除)各自有一条策略,在服务端执行。
主权 AI 工作空间这个提法之所以存在,是因为一个记忆存在别人账号里的分身,在那个账号出事的那一刻就不再是你的了。模型按任务路由,Llama、Qwen 这类本地模型跑在设备上,日常活不产生按 token 计的费用。关于主权 AI 工作空间的完整说明,见产品页面。
它不能给你的:最强的推理能力——最难的问题上,云端前沿模型仍然领先;它不能替你省掉那个配置的下午;它也不能消除审批疲劳,一个真正起作用的边界反而会让它更明显。如果它不适合你,完全没问题——上面每一个测试,用在你正在考虑的任何工具上都成立。
13常见问题
AI 分身就是有张脸的聊天机器人吗?
不是,而且脸是最不重要的部分。区别在于它能不能行动、边界是不是在模型外面执行、会不会署自己的名、交不交回一份工作记录。有卡通头像但没有动作面的,还是聊天机器人。
我一个人干活,需要吗?
你恰恰是最需要的,因为你同时是整条审批链。价值不在「分权」,在于你去开会、在地铁上、在睡觉的时候活还在往前走,而且你事后能看到走到了哪。
能把现有聊天机器人改成分身吗?
通常是重建而不是加装。对话窗口里的工具,给你的是没有边界的动作、没有凭据的产出。缺的正好是最费工的那几块。
怎么知道分身没编东西?
靠设计,不靠指望。要它的记录,看它有没有指出读的是哪个文件。指不出来源的系统,在概率上有时就是在指向空气——而且它编的时候一样自信。
最该怕的失败是什么?
不是答错,是对错对象做了正确动作——正确的那封邮件发给了错的客户。所以动作类型要分开配策略,所以审批日志比聊天记录重要。
它会取代我现有的聊天订阅吗?
多数是互补。聊天适合边想边说、起草、提问;分身适合有交付物、有接收方的活。大多数团队最后两样都留着,有用的问题是:你反复做的那些事里,哪些最后是有一件东西交出去的。
多久才能真正用起来?
一件范围窄、材料齐的活,配置一个下午、校准一周。一个宽泛的角色,更久,而且第一版会比你想的差——那种差会告诉你你的流程原本是什么样的。