一个团队迟迟不换模型,拦着的往往不是新模型不够好。新模型多半更强,单价还更低。拦着的是旧助手已经被教熟了:三月份有人纠正过发票编号的规则,某个客户上午十点前绝对不能发邮件,项目里那套名词表磨了一个季度才定下来。谁都不想从头再教一遍,而且谁也说不准,换了模型是不是真要从头再教。
AI 记忆迁移,指的是把助手积累下来的记忆(学过的事实、挨过的更正、偏好、项目上下文)搬到另一个模型或另一套运行环境上,不用重新教。有没有这个能力,不是看功能介绍页,是看架构:看记忆到底放在哪。记忆放在你自己手里的一个文件里,换模型就是换零件;放在别的任何地方,就总有一部分留在原地,差别只是留下多少。
这个问题现在躲不开了。48 小时之内,OpenAI 发布了 GPT-6.2 Astra 和 Sol(11 月 17 日),Google 发布了 Gemini 4 Neon,微软在 Ignite 上一口气发了七个模型,包括 MAI Code 2(11 月 18 日)。哪一款值得换,是另一个问题,取决于你分得清 AI 分身和 AI 模型的区别。更窄也更实际的问题是:你点头换的那天,助手的记忆会怎么样。短答案是:看记忆住在哪,总共只有四个可能的住处,今天下午就能查清自己属于哪一种。
01记忆条目里到底存着什么
「记忆」听起来是一样东西。实际上,一个干了几个月活的助手,肚子里存的是好几类条目,搬家的时候各有各的脾气。
| 条目类型 | 长什么样 | 怎么来的 |
|---|---|---|
| 更正 | 「发票编号每个财年重排,旧的别动」 | 有人发现错了,说了一句 |
| 偏好与家规 | 「报价用客户的币种;摘要不超过 200 字」 | 教一次,指望它记一辈子 |
| 项目与客户上下文 | 「汉堡那个客户用 2024 年费率表,别用官网挂的」 | 一次次对话里攒出来的 |
| 计费与流程事实 | 成本口径、审批链、谁签字 | 建档时录入,后来慢慢修 |
| 过程性笔记 | 「六月试过那个库,重试会炸」 | 踩过的坑的记录 |
表 1. 记忆条目的五种类型
条目进来的渠道有三种,渠道基本决定了条目的质量。一种是建档时专门教的,措辞一般比较规整。一种是干活当中顺口纠正的(「不对,用另一张费率表」),又短又依赖当时的上下文,彼此还可能打架。还有一种压根没进系统:它住在某个同事脑子里,靠这位同事每隔几周把同一条约束再讲一遍。第三种平时看不见,一到迁移就现形,这也是迁移让人清醒的原因之一。
量涨得比想象快。一个团队每个工作日纠正三条,26 周后大约就是 390 条(按每周五个工作日算,假设中途没有忘掉的)。这 390 条几乎每一条都是用一次错误换来的:一张开错的发票,一个被惹毛的客户,一个浪费掉的下午。教一次家规,以后谁都不用再重复,这正是给助手配记忆的意义。这层积累为什么应该归你、而不是归某个厂商账户,是 AI 分身记忆归属要回答的问题;这里关心的是更机械的一件事:换模型那天,这些条目里哪些能跟着走?
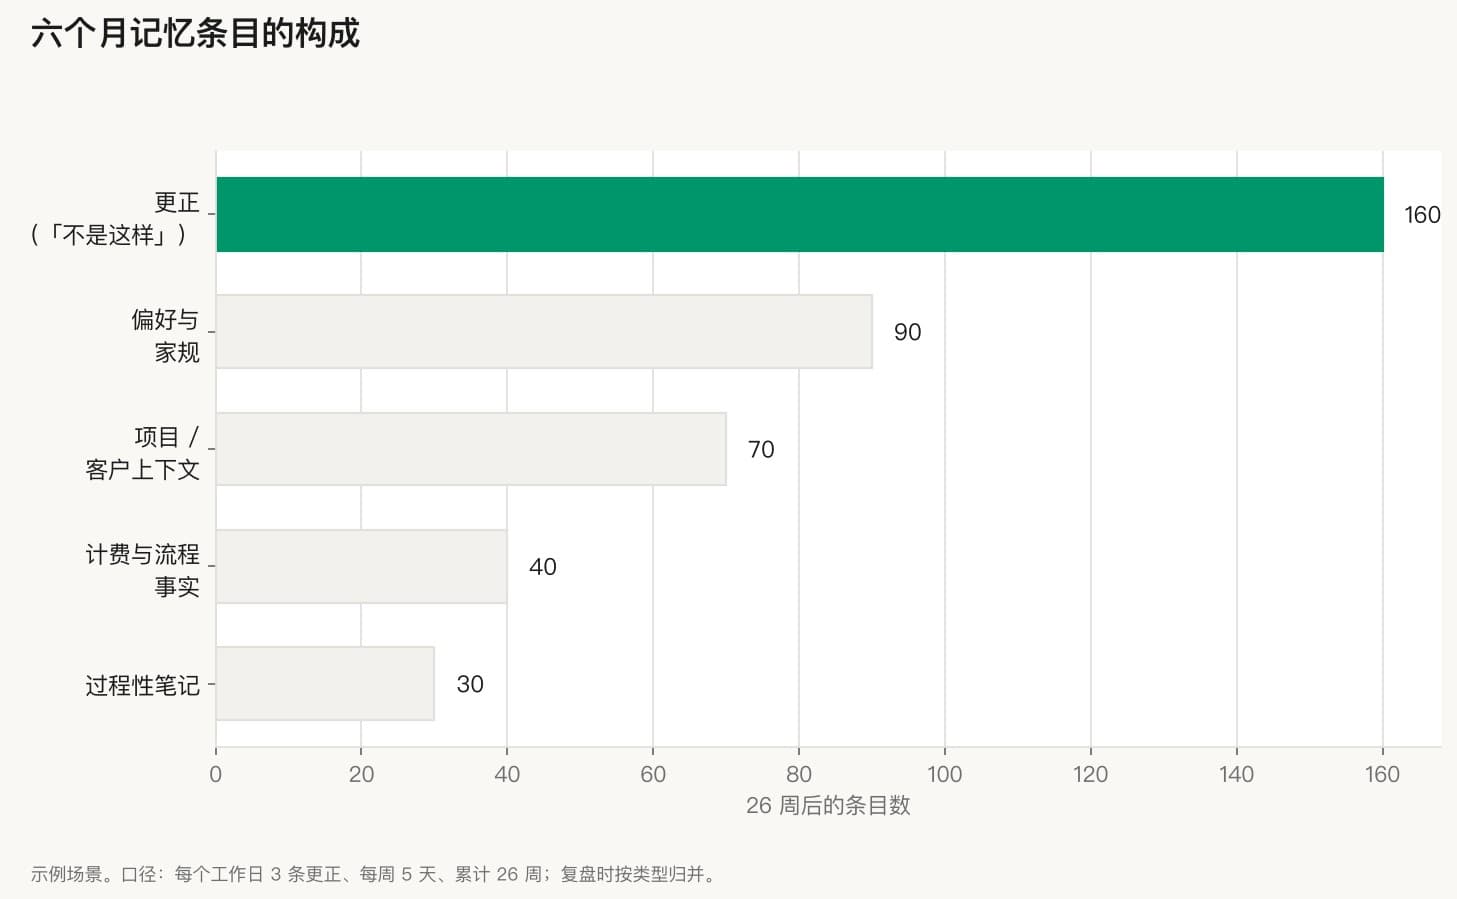
图 1. 六个月记忆的构成:示例场景,假设每个工作日 3 条更正、每周 5 个工作日、累计 26 周,条目按类型归堆。
02记忆的四个住处,各自怎么搬
助手学到的东西,只可能存在四个地方。放在哪,比用谁家、用哪款模型都更能决定换一次要付出什么。
微调进模型权重。有的团队靠微调来固化行为:拿自己的例子训模型,训到它按自己的路数回答。固化风格和输出格式,这条路走得通,而且一度会让人觉得这才是最深的记忆。它也是整个话题里最搬不动的东西。进了权重的内容列不出来、看不见、导不出、搬不走,没有一个文件可以复制,也没法问模型它都被教过什么。基础模型一退役(退役时间表握在厂商手里),这份微调就跟着作废,活从头来。一条实用的规矩:微调只用来管「怎么说」,永远别用来存「你的生意是什么」。
上下文窗口和系统提示。贴在系统提示里的指令,哪里能贴字就能搬到哪里,所以这一层看起来可以迁移,提示文件本身也确实可以。把系统提示放进代码仓库、留版本记录的团队,在这一层已经做对了。麻烦在没写进提示里的那些:长对话里助手慢慢对上的语气,从你最近二十条消息里捡起来的简称,还有那种「这个我们聊过」的默契。这些东西每开一次新会话就清零重来,换不换模型都一样。一个行为真要紧,就得写到对话之外的某个地方,否则它从来就没被保存过。
厂商账户记忆。主流助手产品现在都有账户级记忆:你告诉过它的事,跨会话还在,而且跨模型版本也还在。这一点得说公道话:只要你用一家的应用、一直待在里面,模型升级一般动不到这一层,「换了新模型就全忘光」这种担心,在同厂换版这个场景下是被夸大了。边界在两头。换到另一家厂商,没有任何导入仪式等着你,没人做一个按钮去吃进竞争对手的记忆。换一套运行环境(自己搭编排、调同一家的接口),应用里的记忆功能通常也不在了:它属于应用界面那一层,账户里存的记忆不会跟着 API key 走。你一般能在设置页里翻看、修改单条记忆,这比权重透明,但比一个文件差得远。记忆是真的,只是托管在别人那里,能搬去哪,规矩由托管方定。
你自己手里的一个文件。第四个住处最不起眼:结构化的记忆条目,放在你管得着的存储上。好用的格式朴素到无聊:每条带内容、教它的日期、状态(生效还是已作废)、来源(谁教的,或者出自哪段对话),最好再注一句当时是对着哪款模型调的。这里朴素的文本比花哨的数据库好,因为这个文件唯一的任务,是十年后不管你在跑什么,它都还能被读懂。模型升级弄不丢它,因为模型从来没拥有过它;换厂商弄不丢它,因为它从来不在厂商的账户里;换运行环境弄不丢它,因为它跟你的其他文档一样跟着走。身份和权限也值得这样单独分层,所以 AI 分身身份通常被设计成独立的一层,而不是留在某一个平台里面;记忆管的是分身「知道什么」,身份管的是它「可以做什么」。
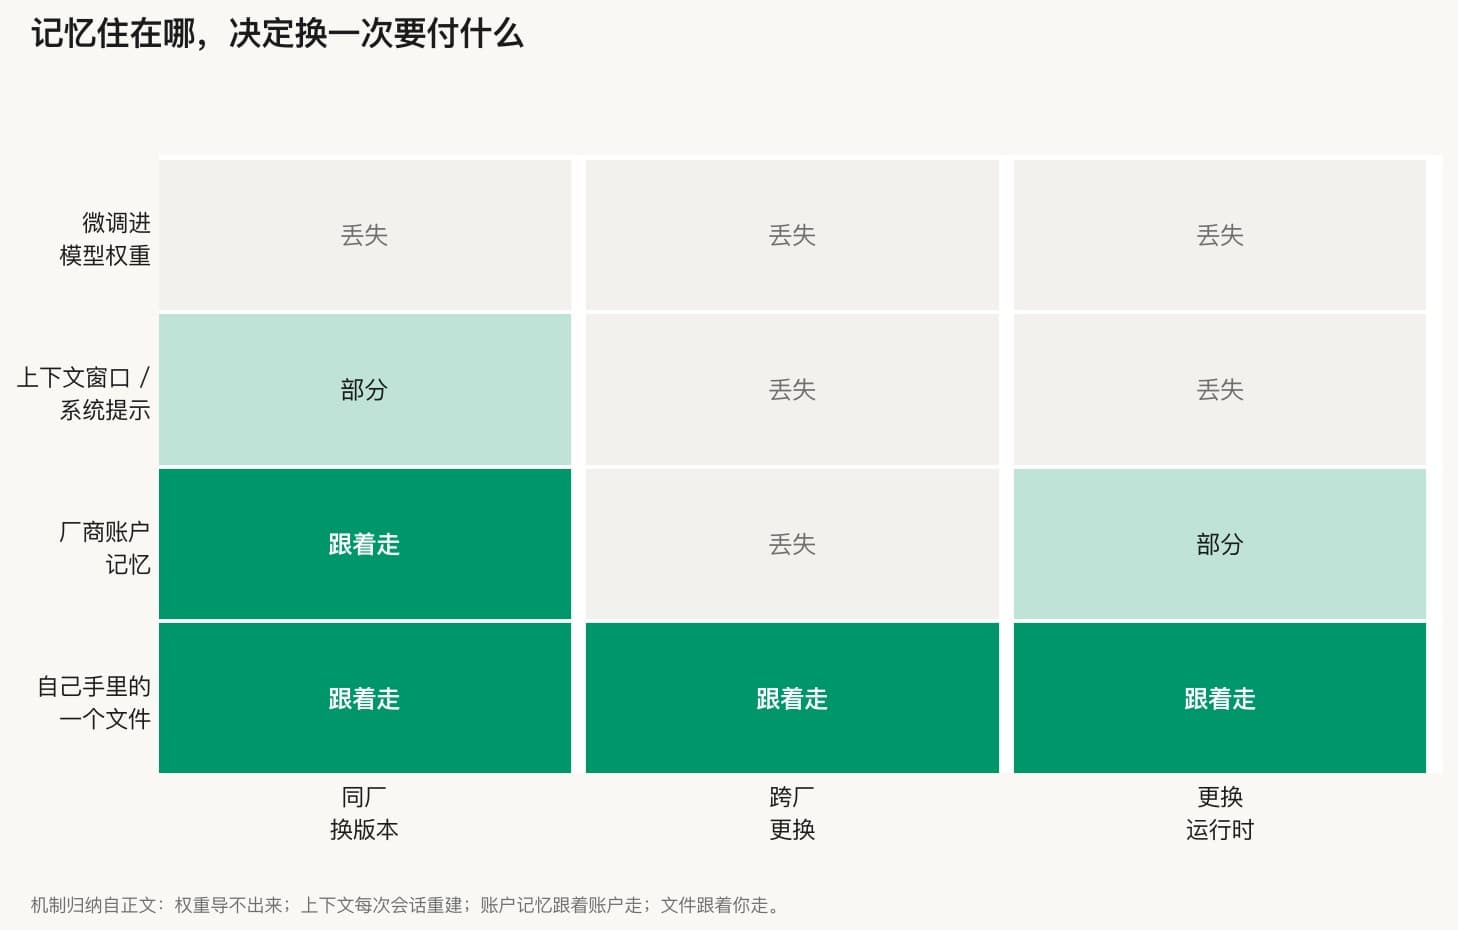
图 2. 记忆住在哪,对上三种更换方式。矩阵依据正文机制:权重不可导出,上下文按会话重建,账户记忆跟账户走,文件跟你走。
矩阵里只有一行三格全绿。把记忆放进文件的全部理由,就在这一行里。
对照矩阵给自己定位,三个问题就够,一个下午能查完,不用提交任何工单。今天就能导出一个文件、里面是助手被教过的东西吗?能,你就在最下面那行。答案如果是「有个设置页,能一条条翻」,你在账户那一行,顺便值得把那一页翻一遍做个盘点。要是老实话是「行为在微调里」或者「它就是从对话里知道的」,你在最上面两行,上面那些你在乎的东西,这周就该写下来,别等哪次迁移替你把道理讲明白。
03换模型时,哪些跟着走、哪些留在原地
就算你的记忆状况很好:条目结构化、导得出、归你。换模型也不是什么都能带走。有三样东西无论你多自律都会留在原地,提前知道,意外就变成了清单。
场内习惯留在原地。老模型用了几个月之后那种「懂你」,一半是真记忆,一半是最近上下文垫出来的默契。新模型上来是平的。记忆文件能在会话里把事实找回来;熟络感要靠几天正常使用才重新长出来。这是最容易被误读成「记忆丢了」的落差。丢的其实是默契,它自己会回来。这一点值得提前告诉团队,免得头一周干巴巴的回答全被算到迁移头上。
对着某款模型调的提示词技巧留在原地。你为了逗出某个行为而反复打磨的措辞,赌的是那款模型的脾气。有些换个模型还灵,有些会悄悄反过来:按住这款话多的指令,另一款可能读成放开说的许可。提示词偏方就该当成耗材对待;记忆条目里凡是存了这类偏方的,注一句当时对着哪款模型调的,下次迁移就知道该重测,而不是直接信。
嵌入索引留在原地,这一条是纯机制问题,值得讲透。检索系统的原理,是把文字折算成嵌入(embedding):一长串数字,相当于给每段话在一个几何空间里安排一个座位,意思相近的段落坐得近。这些座位号只在算出它们的那个模型里才有意义。换一个嵌入模型,旧座位号不算错,是没意义了,好比拿着另一座城市的门牌号找路。新模型算出来的查询,落到旧模型排的座位表上,八竿子打不着,检索质量就这么塌下去,而且全程不报一个错。解法是例行公事:同一批文档,用新嵌入模型重算一遍索引。文档本身好好的,索引是派生出来的产物,花点算力和耐心就能重建。跳过这一步的团队,体感是「新模型变笨了」,其实模型没有任何问题。整个话题里没有绕路可走的技术步骤就这一个,清单上要拿粗笔写。
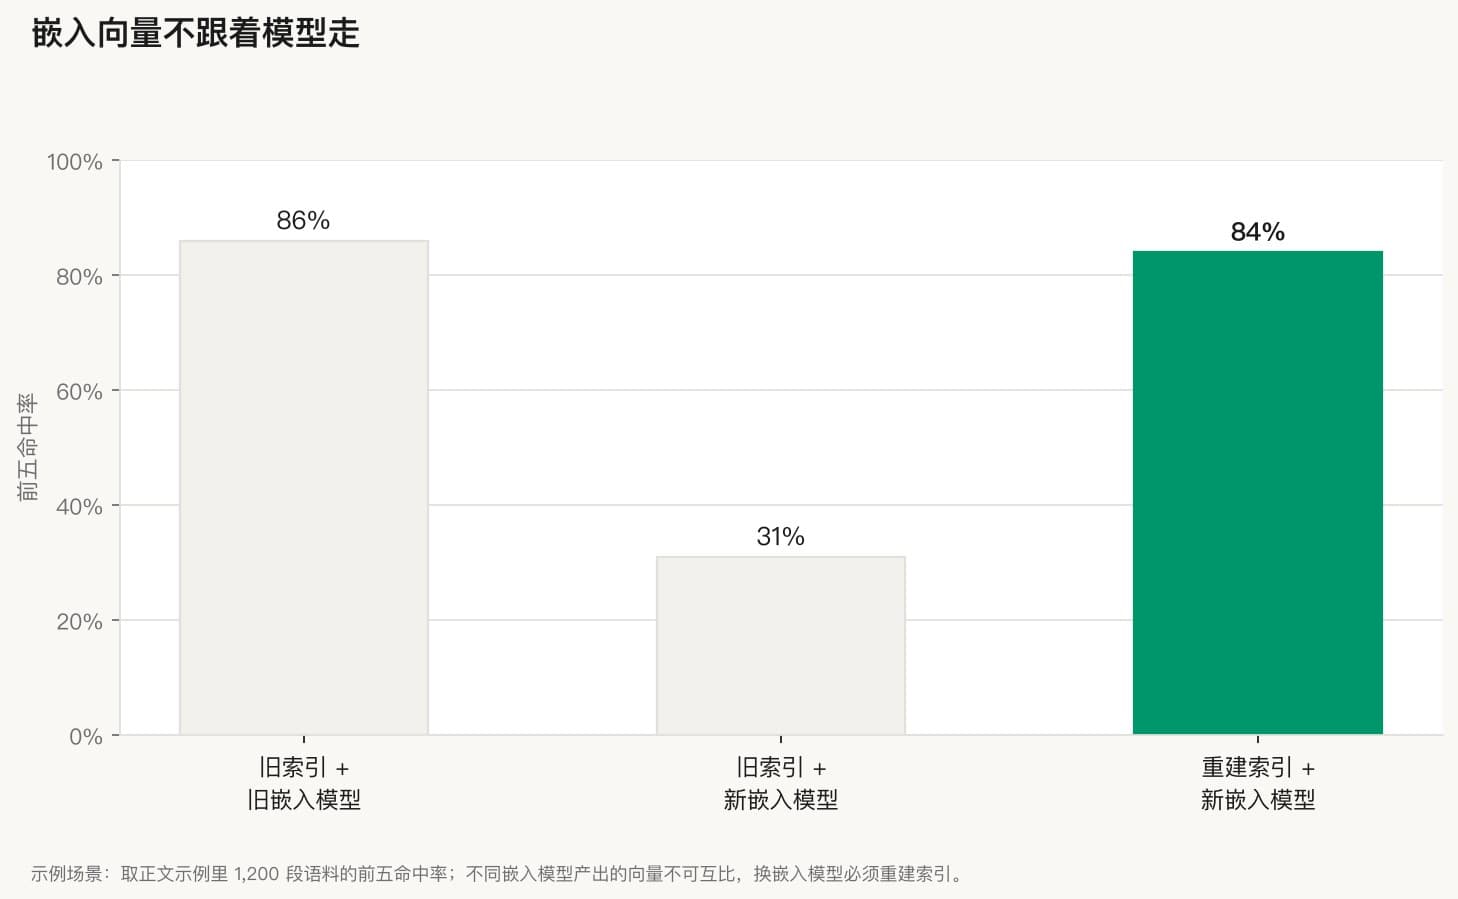
图 3. 嵌入向量带不到新模型:示例场景,1,200 段语料的前五命中率,混用向量时静悄悄地失效,重建索引后回到基线。
还有一样东西严格说不在范围内,但值得占一行:凭据、工具连接和权限不是记忆,也永远不跟着记忆走。每套运行环境各管各的授权,这是正确的设计。要是导出的文件里悄悄带着能用的凭据,那它就成了一套入侵工具包。到了新环境要重新授权工具,这是单独一步、有单独的负责人,预算要打进迁移里,别拖到切换当天下午五点才发现。
再分清一对概念,下游能省掉很多糊涂账。多数助手产品都能把聊天记录下载成文件,这个导出有用。但它是日志,日志和记忆是两回事。日志记的是「有四次有人聊过发票编号」;它不记这四次里哪一次定下了现在生效的规则。想想那四段对话的原文里都有什么:一个猜错的、一个改了一半的、一个给某客户开的例外、最后定下的那条,按时间排着,没有任何记号指出最后那条是幸存者。记忆是带状态的:生效、已作废、是错的。状态恰恰是聊天记录里没有的东西。聊天记录的导出是记忆文件的原材料,是活儿的开头。把它当成品,团队就会信心十足地把自己过时的指令原样导回去。
04从头再教一遍要花多少时间
不迁移记忆,就得重教。重教是什么形状,最好在默认选它之前看清楚。
账面好算。半年场景里那 390 条,每条按保守的两分钟重遇、重讲,加起来约 13 个小时(假设中途没有忘掉的、也没新增)。相当于一位资深员工两个工作日,全花在把团队已经花钱学过一遍的事再讲给助手听。对一个三人小店,数字更小,疼得更真:重教的那个人,同时也是干其他所有活的那个人。
但这还是乐观版本,因为重教不会老老实实坐下来连上 13 个小时。条目怎么来的,就会怎么回来:一次错一条。助手又把旧发票重新编号了,因为拦着它的那条更正没了。报价又用错币种发出去了。接下来几个星期,团队把已经付过一遍学费的错误再挨一遍,每次都是错误本身加收拾残局加重新讲解。假如 390 条里哪怕三分之一是靠「再错一次」找回来的,每次连错带改平均搭进去二十分钟,摊下来就是大约 40 个小时、拉扯一个月的小乱子。所以凡是真干过一次的人,没人把不带记忆的迁移说成「两天的活」。
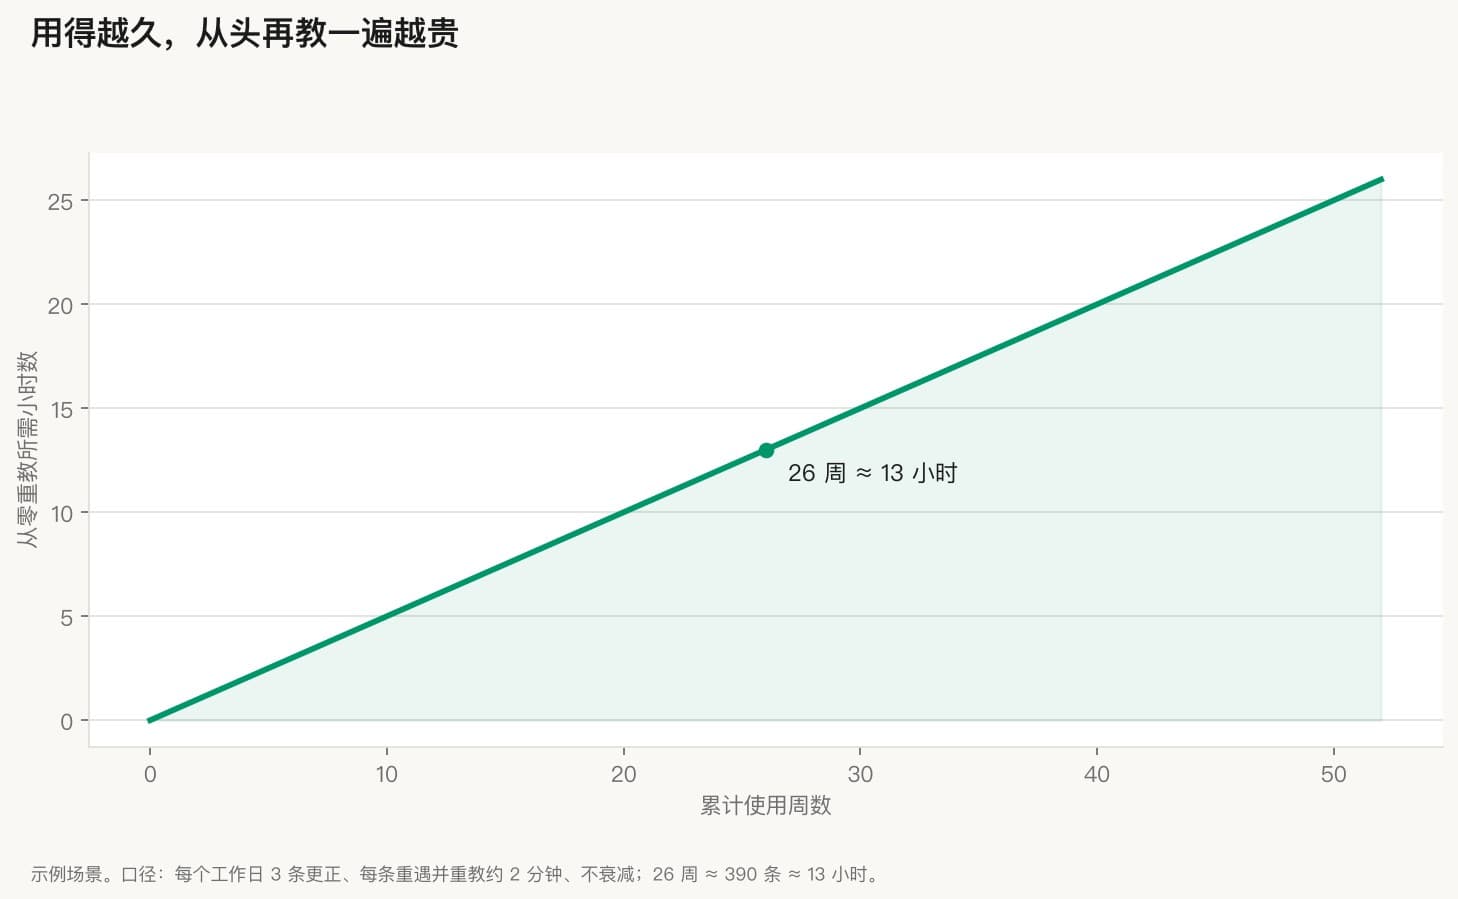
图 4. 重教成本随使用周数增长:示例场景,假设每工作日 3 条更正、每条 2 分钟重教、无衰减;26 周 ≈ 390 条 ≈ 13 小时。
这笔账还是另一件事的幕后机制:团队明明用腻了某个工具,却一直走不了。换,就要重教六个月的更正,于是不换看起来很理性。它会一直显得很理性,直到更好的模型已经领先两代,每个月落下的差距比当初搬一次家还贵。
05决定换模型之前,要先导出和验证什么
保得住记忆的迁移就四步。没有一步聪明,每一步每周都有人跳过。
先盘点。写下来记忆现在都住在哪:厂商应用里的账户记忆、仓库里的系统提示、检索语料和它的索引、聊天记录,还有没写下来的那一层:只存在某个同事脑子里、因为「助手反正知道」而从没落过字的规矩。每一项旁边标个数。盘点清单常常是整件事里最让人清醒的一份材料,而且能复用:哪天有人离职、分身留下,公司场景里分身记忆归谁,判的也是这张图。
把能导的导出来,导成你读得懂的格式。能用的记忆文件,每条带内容、教它的日期、状态、来源。聊天记录的导出要过一遍提纯:按主题归堆,每个主题留最新的那条规则,标出它顶掉了哪条,死胡同删掉(除非死胡同本身就是教训)。两百来条也就一个下午,还顺带做了次审查:你多半会翻出互相打架的规则,和没人记得定过的规则。每条的检验标准很糙:一句话讲不明白给新员工听的,就还不是记忆,是口口相传。
换绑,旧绑定先留着。把助手指向新模型,导入记忆文件,检索索引用新嵌入模型重建完,再去评价检索好不好。旧配置保持可运行一到两周。这是个配置选择,而且便宜:并行绑定花不了什么钱,却能把「迁移失败了」从一场事故变回一次对比,挑个清净的下午两边各跑一遍就能看。
用金标题目验证。换之前,写下五到十道答案可以核对的题(费率、编码、家规、一道只有一个正确答案的计算),记下现在这套配置的答案。换绑之后,拿同样的题问新配置,逐题对着记录比。通过率让损失几分钟内现形,不用等几个星期。而且错题不只是红叉,它指向具体某一层:少了一条事实,是条目没导入;翻出错的文档,是索引没重建;答案对了格式不对,是提示没带过去。金标题目集不大,但它是诊断工具,以后每次换都用得上。
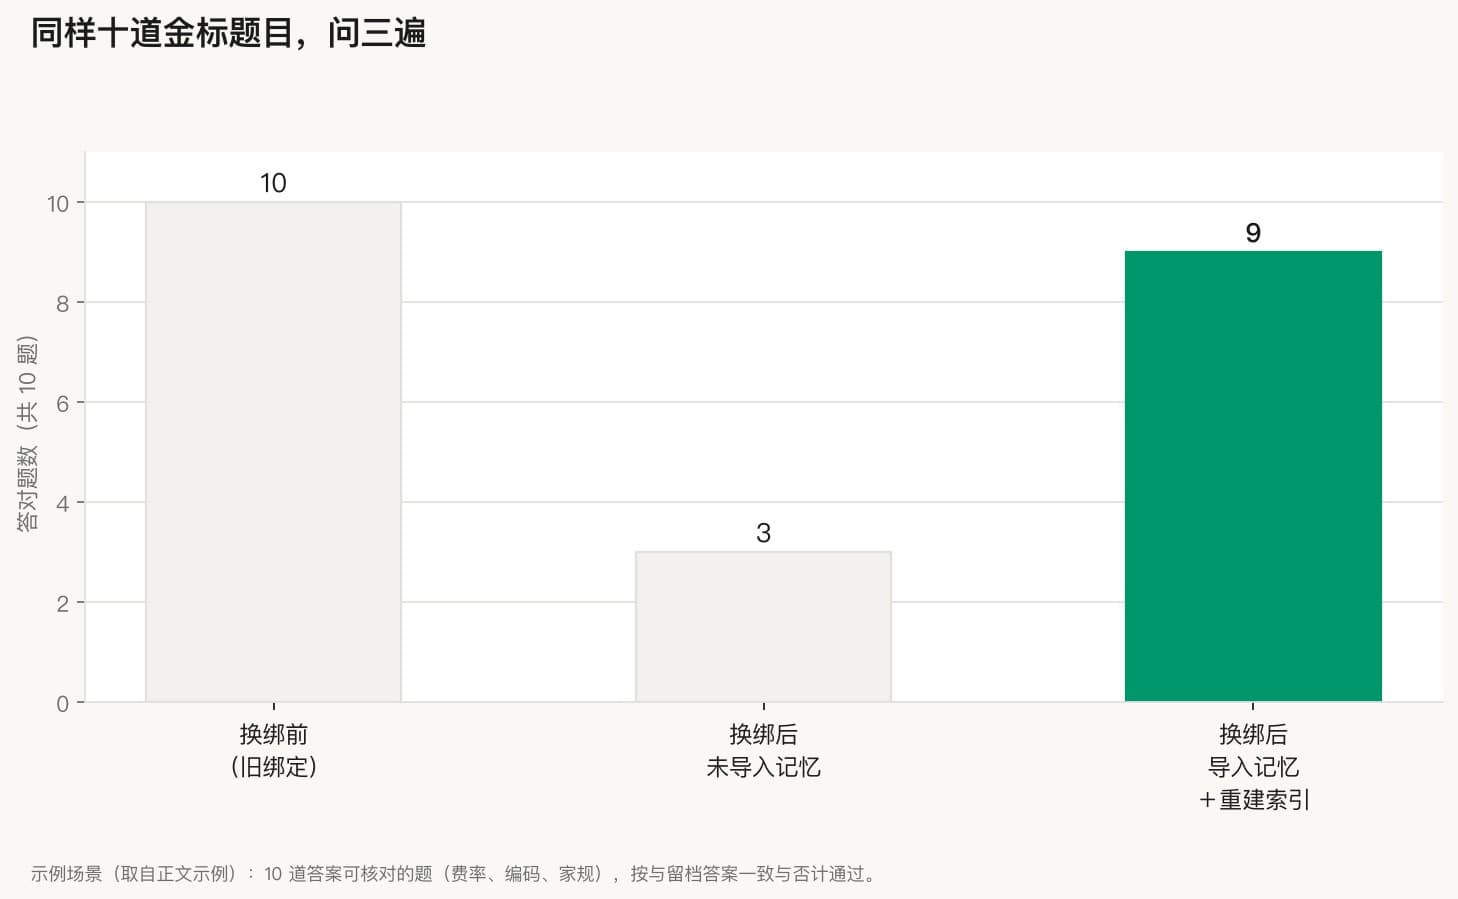
图 5. 十道金标题目问三遍:示例场景,同一组十道题在换绑过程中各阶段的通过率。中间那根柱子就是跳过导入的样子。
时机也算流程的一部分。换绑放在清净的一周跑,别撞上季度结账或产品上线;告诉团队哪几天是对比窗口,怪答案要上报,不要各自悄悄绕过去。十个人盯着的迁移,几天能暴露的问题,一个管理员自己要找一个月。
06示例:一家十人咨询公司怎么搬
设想一家十人咨询公司,助手用了 14 个月:客户偏好、费率表、1,200 段历史提案组成的检索语料,还有一长串零碎更正。合伙人想换刚发布的某款模型,没人想把第一年重活一遍。
盘点查出记忆住在四处:258 条账户记忆、两份已进仓库的系统提示、带索引的检索语料、从头攒到现在的聊天记录。提纯花了一位合伙人大半个下午:合并重复、丢掉已作废的,还翻出两条关于四舍五入的指令互相打架、而且都在生效,最后出来一份 212 条的记忆文件。金标题目十道(三道查费率、两道问家规、三道靠检索、两道算数),答案在动手之前全部留档。
换绑到新模型后,金标第一轮 6/10:三道错在检索,语料还挂着旧嵌入模型的索引,1,200 段重建完三道全对;一道错在一条费率条目,它从来没进过账户记忆,只躺在一段提纯时漏掉的聊天记录里,重教一次补进文件。第二轮 10/10。整场迁移合计一天半,大头是提纯;对照的是预估两周以上的「靠再错一遍找回来」。旧绑定安静地跑了十天后退役,212 条的文件、金标题目集和盘点清单全部留下,下一次换什么都接着用。
07一周三款旗舰模型
11 月 17 日这一周把道理压缩进了 48 小时:OpenAI 的 GPT-6.2 Astra 和 Sol,Google 的 Gemini 4 Neon,微软以 MAI Code 2 领头的七款。没有哪个团队会挨个评测。要紧的是节奏:旗舰发布的频率已经快过多数团队的季度计划,而这一层你在外面一点也控制不了。记忆可迁移的团队,每次发布是一个期权,行权还是放掉,按价值定。记忆压在某家账户或某款权重里的团队,每次发布都是一个没排进日程的迁移项目,价码几个月前那个架构决定就定好了。
08KarmaBox 如何落地记忆迁移(产品说明)
我们自己的产品 KarmaBox 就建在这个前提上:分身的记忆存在你自己机器上的一个文件里,模型才是可替换的零件。
Karma 里干活的单位是 AI 分身:一个有自己记忆、技能和权限的助手,定义在任何单一模型之外。分身的记忆就是上文矩阵奖励的那种可携带文件:自「统一换身」上线(2026-10-24)起,同一个分身在云端、Mac、KarmaBox 设备和 KarmaLith 之间迁移,记忆不丢、不用重训。店里设备临时坏了,分身自动在云端接着干,记忆还是那份记忆。上文那四步迁移并没有消失,它变成了被托住的路径:搬分身这个动作,把导出和换绑并成了一步;留给你的,是只有你能做的那一步:金标验证。
这套设计把「四个住处」的问题挨个接住了。记忆从不微调进权重,所以任何模型退役都困不住它。它也不锁在哪家的应用界面里,所以试一个新模型不等于跟旧账户离婚。文件放哪由你定:在主权 AI 的架构里,它就放在你办公室的硬件上,旁边是本来就留在你机器上的业务对象、文档和知识库。这跟 AI 工作负载的数据驻留是同一套逻辑,只是这回管的是助手学到的东西,不是你喂给它的东西。
连续性盖住的不只是记忆文件。分身的知识库和文档跟着分身走,技能和权限档位定义在分身身上、不挂在某款模型上,所以换模型不会重置它能做什么、也不会弄丢它干活用的材料。真正需要你立个规矩的是备份:记忆文件就在你的存储上,把它编进你其他业务文件已有的备份轮换里。每周往自己管的盘上拷一份,一分钟的事,却能把最坏的迁移剧本压成一句话:把文件恢复回来,跑一遍金标。
模型那一侧被故意做得很无聊。云端模型是平台内置的,不用申请 key,不用配置任何东西就能试。某个任务要用云端模型、要花钱的时候,分身先问你,等你批准。所以试这周的新模型是一个由你批准的决定,换模型的成本是点一次确认,不是折腾一下午环境。敏感的活可以留在本机分身上;云端模型留给你决定送出去的那部分任务。
「记忆这层真的待在原地」是一句可以验证的话,不是口号。我们自己的断网实测(2026-10-28 至 10-30,我们公布过的数字):一台设备拔着网线跑了三天,最忙那天本地推理 197 次,业务数据出域 0 次,设备页全程显示「nothing has left」,而 886 段对话、2 个知识库、24 条记忆一直原地坐在设备上。那 24 条,就是前面说了一路的那个文件安安静静躺着的样子,放在主人指得出来的硬件上。能拔着网线干活,是 AI 主权分身六条标准里的一条;记忆原地不动、换了模型也还在,是六条里跟换模型这件事贴得最近的那条。
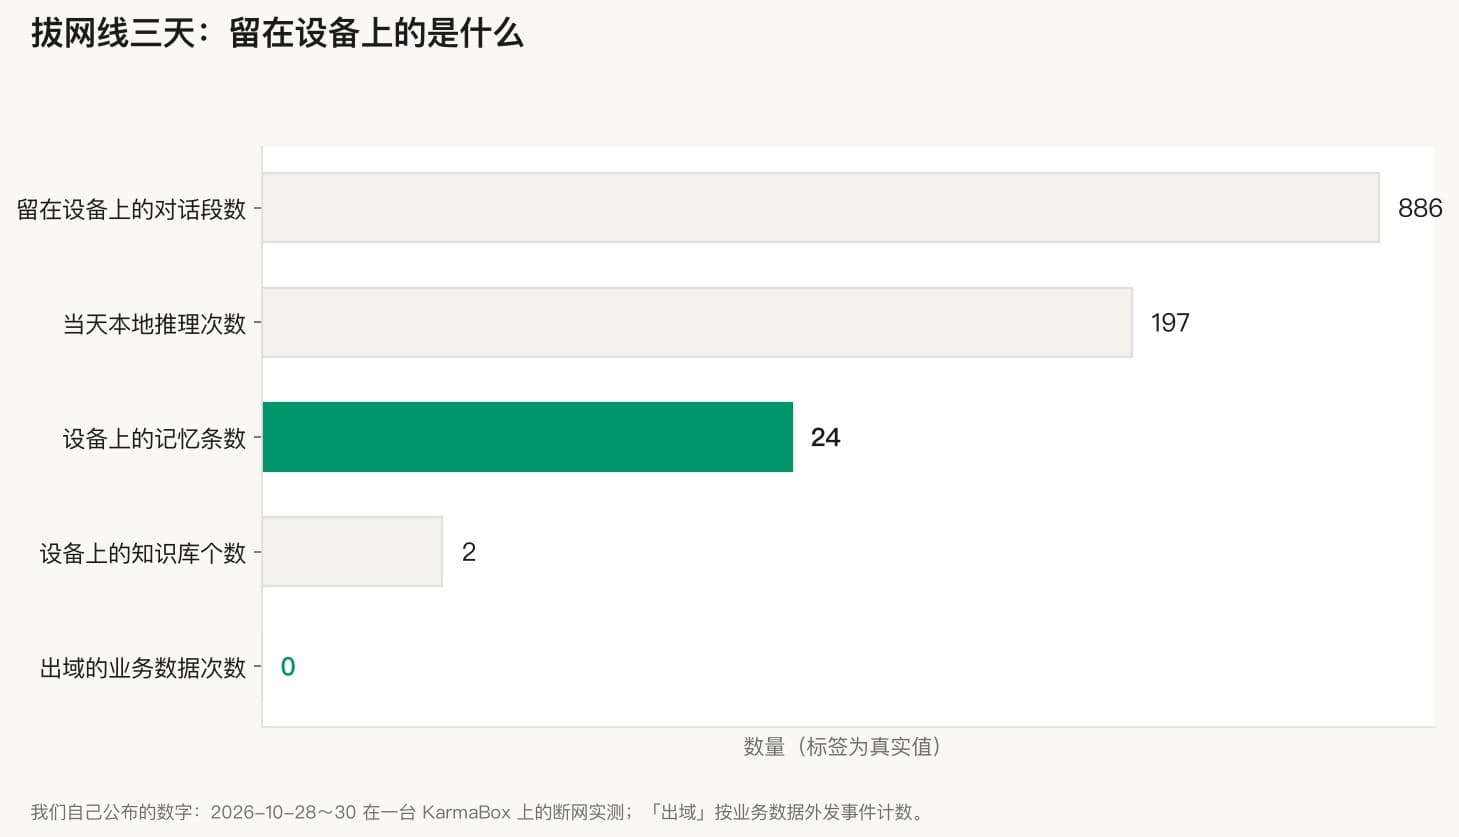
图 6. 三天断网实测,留在设备上的东西:我们自己公布的数字,2026-10-28 至 10-30,设备网线拔除状态。
| 前文的问题 | KarmaBox 怎么做 | 你要做的设置 |
|---|---|---|
| 记忆住在厂商账户里,跨厂不走 | 分身的记忆是你机器上的一个文件 | 把记忆文件定期备到自己的盘 |
| 换运行环境、换硬件就得重教 | 统一换身:云端 / Mac / KarmaBox / KarmaLith 之间迁移,记忆不丢(2026-10-24 上线) | 搬完跑一遍金标题目 |
| 想试新模型,怕配 key 折腾环境 | 云端模型内置,不用配 key;要花钱的调用先问你批 | 批,或者不批 |
| 「数据在你设备上」只是一句话 | 断网实测:886 段对话、2 个知识库、24 条记忆在设备上,出域 0 次 | 看设备页的「nothing has left」 |
| 搬完没法证明记忆还在 | 可核对的事实教一次,用金标题目验证 | 留 5–10 道答案留档的题 |
表 2. KarmaBox 怎么把「记忆可迁移」落到五个具体问题上
金标验证有一个自家的例子。KarmaBox 内测实拍(2026-11-15,测试号)里,选品分身被教过一次成本口径:采购价、头程、FBA 费用、佣金、关税、汇率。之后问它一款瑜伽垫的到岸经济账,28 秒回了每件净利 12.55 美元、盈亏平衡 ACoS 41.84%,跟人工复算一致。这道题天生就是金标题目:一个可以核对的数字,底下静静压着每一条教过的口径。任何一次换身或换模型之后,同一道题要么再次回出 12.55 美元,要么精确地告诉你哪条口径丢了。
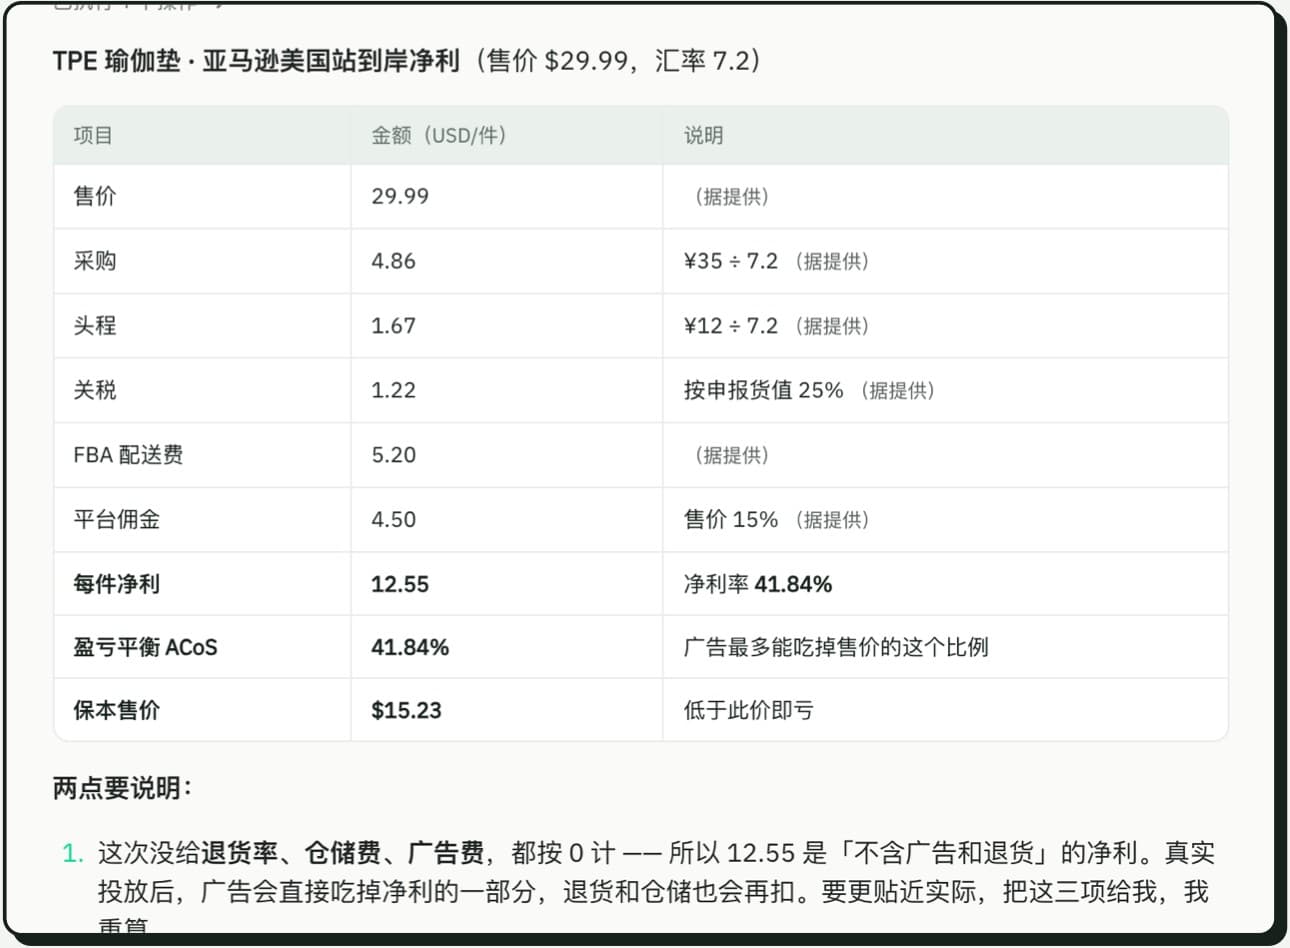
图 7. 一张界面卡片截取(非整页),来自 2026-11-15 的一次完整运行记录:教过一次的成本口径,一个可核对的答案。
09记忆迁移解决不了什么
一份干净的记忆文件,填不平模型之间的能力差。新模型要是在你的领域里就是推理得差,带着满分的记忆它照样差,金标全过,日常质量照跌。迁移保住的是你教过的东西;模型拿这些东西能干成什么样,它一个字也保证不了。
它也带不走语气。同一份记忆文件给两款模型,写出来还是两种味道,恋旧的团队可能要几个星期才不再别扭。它也免不掉嵌入重建:只要你跑检索,每换一次嵌入模型,这笔算力就要再花一次,没有头。文件本身还是个要养的东西。条目会过期;讨厌早晨收邮件的那位客户换了工作;费率表换了新版,文件里那条旧的就成了一本正经的错误答案。得有人按节奏修剪:一个季度抽十五分钟,把不再适用的退役、把核对过的标上日期。不修剪,记忆文件会慢慢变回它本来要取代的那堆口口相传。
剩下的账要起个名字:再验证成本。每次更换,哪怕换得再完美,都要付一轮验证:金标、几天观察、一次重建索引。迁移能力把一次搬家从没边的工程变成一套流程,但流程仍然有价。在一个 48 小时蹦出三款旗舰的时段里,这笔账你每点一次头就要付一次。
10常见问题
换模型等于助手全忘光吗?
不等于,结果完全取决于记忆住在哪。账户级记忆扛得住同厂的模型升级,但不会跟你去另一家;微调进权重的,怎么换都丢;放在你自己文件里的,三种换法都丢不了。
我用的产品自带记忆功能,还不够吗?
只要这家厂商、这个应用和你这个账户都是你长期计划的一部分,就够。这个功能是真的,也确实扛得住该厂商的模型升级。但它不是导出格式,默认也不可携带,所以把它当便利层用,正本放在你自己管得着的地方。
嵌入向量能带到新模型上吗?
不能。嵌入向量是某一款模型空间里的座位号,到另一款那里没有意义。文档带得走;索引必须用新嵌入模型重建,否则检索质量会无声无息地塌掉。
金标题目要准备几道?
五到十道通常就够抓出大面积的记忆丢失,多了反而没人坚持跑。前提是每道只有一个可核对的答案,而且盖住不同的层:一条教过的事实、一条家规、一道靠检索的、一道算数的。答案在换之前留档,题目留给下一次换,期间真实答案变了的题要换掉。
微调算记忆吗?
从功能上算,这正是麻烦所在。微调学进去的东西列不出来、导不出、搬不走,它只以权重的形式存在,而权重的寿命排在厂商的日程表上。实在要微调,就只管风格和格式;事实和规矩放进显式记忆。
决定换用某款新模型之前,关于记忆该先问清什么?
三件事,能落成文字就落成文字:导出通道(到底什么能带走、什么格式)、状态问题(导出的东西分不分「生效」和「已作废」,还是就是一份聊天记录)、重建账单(哪些派生产物必须重新生成、花多少,嵌入索引排第一)。三件都答得上来的厂商,卖给你的是模型。答不上来的,卖给你的是你记忆的住处。
11关于作者
Karma Box 团队发布关于 AI 主权、工作台控制与供应商评估的实用指南。为保证本篇可核查:每条带日期的事实在句内给出处;厂商账户记忆最有力的辩护(同厂换版确实不丢)照写不略;示例场景在图脚注里注明口径;KarmaBox 相关内容单独成节。本篇不做的事:不给本周发布的模型排名,也不替代阅读任何厂商的导出条款。新闻与产品事实核查于 2026-11-19。